

モデルカタログ
最新の人気モデル
ユーザーが最初に試すモデルから始め、その後、出力タイプやワークフローで全カタログを検索・フィルタリングします。
モデルタイプ
ワークフロー
96モデル
全カタログを表示中
bytedance
Seedance 2.0
Seedance 2.0は、テキスト動画変換(text-to-video)、開始・終了フレーム指定(first-and-last-frames)、オムニリファレンス(omni-reference)モードに対応したByteDanceのマルチモーダル動画モデルです。APIXO限定:同時実行数無制限、実在人物のポートレート対応、非公開機能。
bytedance
Seedance 2.0 Fast
Seedance 2.0 Fastは、ByteDance Seedance 2.0のワークフローに対応するAPIXOルートです。テキスト動画変換(text-to-video)、開始・終了フレーム指定(first-and-last-frames)、オムニリファレンス(omni-reference)モードを公開し、オプションで音声、ウェブ検索、480p/720p出力に対応します。
OpenAI
GPT-Image-2
GPT-Image-2は、OpenAIの次世代画像モデルです。より優れた写実性、より精度の高い画像編集、より鮮明な画像内テキスト描画を実現します。
Alibaba
HappyHorse
HappyHorseは、テキスト動画生成、画像動画生成、参照ベースの生成、動画編集の各ワークフローに対応するAlibaba社の動画生成・編集モデルです。720p/1080pの出力に対応しています。
Black Forest Labs
Flux 2
BFLの最新Pro & Flexパイプラインは、Text-to-ImageとImage-to-Imageに対応。1K/2Kの統一価格で、約30sで生成できます。
Nano Banana Pro
Nano Banana Proは、推論に基づいた画像生成、ネイティブ4K出力、多言語タイポグラフィ、空間的に正確な構図に対応した、GoogleのGemini 3 Pro Imageルートです。APIXOでは、このルートで検索グラウンディングをアクティブな制御として公開していません。
midjourney
Midjourney
Midjourneyは、芸術的で高品質な出力で知られる高度なAI画像生成モデルです。text-to-image、image-to-image、image-edit、Vary、Upscaleの各ワークフローをサポートしています。
Black Forest Labs
Flux Kontext
強化されたプロンプト理解力により、優れた品質の出力を実現するプロフェッショナルグレードの画像生成。
OpenAI
GPT-Image-1
GPT-Image-1は、自然言語を理解して高品質な画像を生成する、OpenAIの高度なマルチモーダルモデルです。
Nano Banana
Gemini 2.5 Flash Image Preview(別名 Nano Banana)は、自然言語での画像生成と編集を得意とする高度なAIモデルです。物理法則を考慮した極めてリアルなビジュアルを生成し、シームレスなスタイル変換を実現します。
OpenAI
GPT-Image-2.5
GPT Image 2.5で画像を生成・調整。文章による指示や参照写真から、製品のビジュアル、ポートレート、イラストを作成し、重要なディテールを微調整できます。
bytedance
Seedance 2.5
Seedance 2.5は、参照ベースのより長いストーリーテリングを目的とした、ByteDanceの視聴覚動画モデルです。タイムラインベースのディレクション、マルチモーダルなクリエイティブガイダンス、同期された音声、多言語対応、部分的な修正機能を組み合わせることで、制作チームは個別の短いクリップではなく、つながりのあるシーンを開発できます。
Alibaba
Qwen Image 3.0
Qwen Image 3.0は、1Kと2Kの出力、15種類のアスペクト比、最大3枚の参照画像、オプションのプロンプト拡張に対応した、AlibabaのText-to-ImageおよびImage-to-Imageモデルです。どちらの解像度も同一料金で課金されます。
Alibaba
Qwen Image 3.0 Pro
Qwen Image 3.0 Proは、同じText-to-ImageおよびImage-to-Image契約の上位版です。1Kと2Kの出力が個別に価格設定されているため、ドラフトと最終納品物で請求を分けることができます。
MiniMax
MiniMax H3
MiniMax H3は、テキスト、画像、動画、音声のコンテキストを1つの生成ワークフローに統合する汎用マルチモーダル動画モデルです。ネイティブのステレオサウンド付きで最大2K、最長15秒の動画を作成できるほか、開始・最終フレームの制御、複合メディア参照、モーショントランスファー、マルチショットストーリーテリング、指示に基づく動画編集にも対応しています。
seedream
Seedream 5.0 Pro
Seedream 5.0 Proは、text-to-imageおよびimage-to-image生成に対応した、ByteDanceのプレミアム単一画像モデルです。解像度1K/2K、8種類のアスペクト比、最大10枚の参照画像をサポートし、厳格なカスタムサイズ制御も可能です。
bytedance
Seedance 1.5 Pro
Seedance 1.5 Proは、ByteDanceの秒単位動画モデルで、高速なテキストから動画生成と画像から動画生成を実現します。480p/720p/1080pの出力、オプションの音声、アスペクト比の制御、固定レンズカメラの安定性に対応しています。
Gemini Omni
Gemini OmniはGoogleのマルチモーダル動画生成モデルで、テキスト、参照画像、ソース動画、再利用可能なオーディオアセット、キャラクターアセットIDから動画を生成します。
Alibaba
Wan 2.7 Image
Wan 2.7 Imageは、Alibabaのomni-image APIです。text-to-image、参照ガイド付き画像生成、画像編集、連続画像、高解像度のOmni Image Proワークフローに対応しています。
Alibaba
Wan 2.7
「Wan 2.7」は、テキストから動画、画像から動画、参照ガイド付き生成、動画編集の各ワークフローに対応した、アリババの動画生成および編集モデルです。オプションの音声入力と720p/1080pの出力に対応しています。
Alibaba
Wan 2.6
「Wan 2.6」は、テキスト、画像、フラッシュ画像、参照、フラッシュ参照の各ワークフローに対応した、アリババのマルチモーダル動画生成モデルです。オプションの音声入力と、720p/1080pの出力に対応しています。
seedream
Seedream 5.0
Seedream 5.0は、リアルタイムWeb検索、編集制御、論理的推論機能を搭載したByteDanceの次世代AI画像モデルです。text-to-imageとimage-to-imageをサポートし、解像度2K/3K、複数のアスペクト比、最大14枚の参照画像に対応しています。
OpenAI
Sora 2 Pro
アーカイブ情報。Sora 2 Proは現在APIXOではご利用いただけません。
APIXO
Face Swap
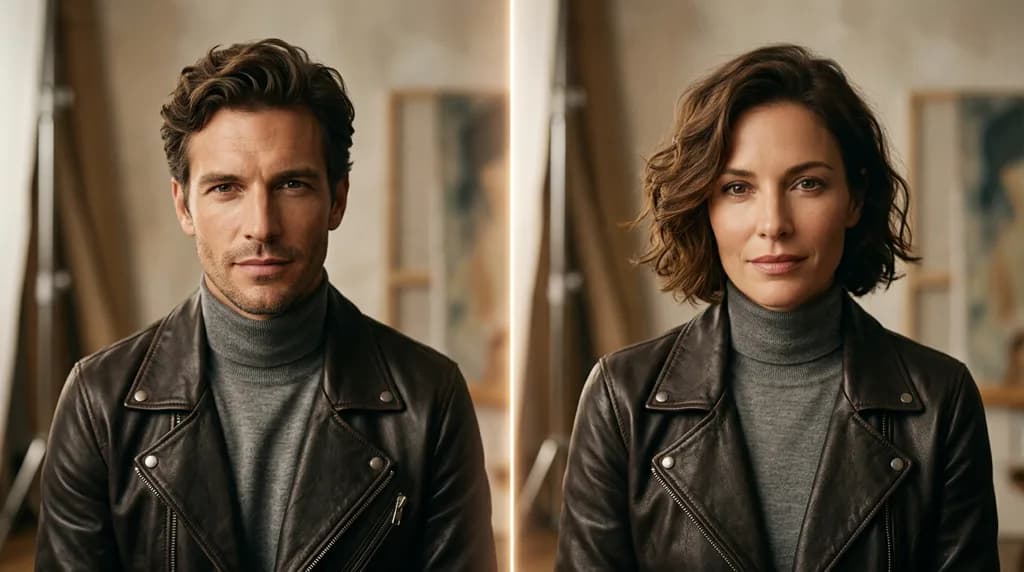
フェイススワップは、APIXOのimage-to-image APIです。ターゲット写真の顔を、参照写真の顔に置き換える機能で、お客様が所有している、または使用が許可されているポートレートにご利用いただけます。
APIXO
Head Swap
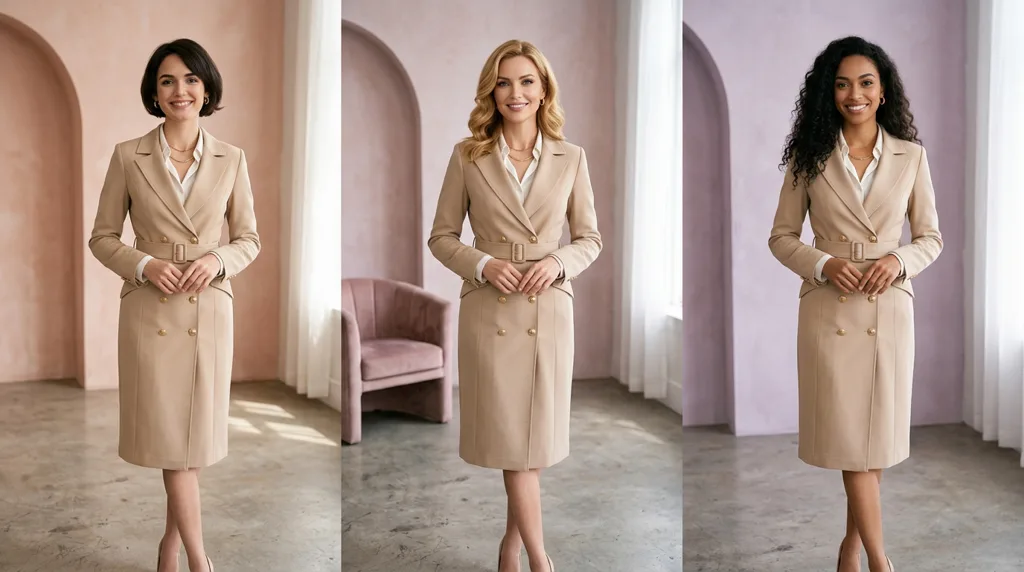
「ヘッドスワップ」は、参照写真1枚の頭部をターゲット写真1枚の頭部全体に入れ替える、APIXOのImage-to-Image APIです。お客様が所有、または使用を許可されているポートレートでご利用いただけます。
APIXO
Video Upscaler
「動画アップスケーラー」は、ソース動画を1080p、2K、または4Kに高画質化するAPIXOのvideo-to-video APIで、ソース動画の秒単位で課金されます。
APIXO
Video Watermark Remover
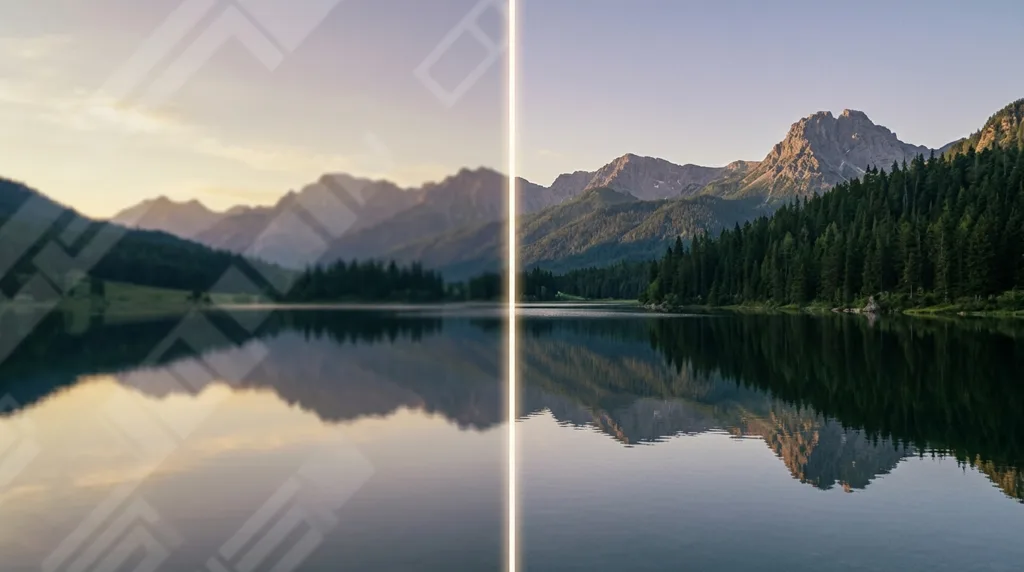
「動画ウォーターマーク除去」は、お客様が所有または変更する許可を得ている動画から、表示されているウォーターマーク、ロゴ、テキストオーバーレイを除去するための、APIXOのvideo-to-videoクリーンアップAPIです。ソース動画の秒単位で課金されます。
APIXO
Z-Image LoRA Pro
Z-Image LoRA Proは、鮮やかなディテールの表現に特化した、テキストから画像を生成する非同期APIです。1回のリクエストで1枚の画像を生成し、アスペクト比プリセット、片側最大2560ピクセルまでの正確なサイズ指定、シード値による再現性、プロンプト拡張といった機能を追加料金なしでご利用いただけます。
APIXO
Z-Image LoRA
Z-Image LoRAは、テキストから画像を生成する非同期APIです。1回のリクエストで1枚の画像を生成し、アスペクト比プリセット、正確なピクセルサイズ指定、シード値による再現性、プロンプト拡張といった機能を追加料金なしでご利用いただけます。
bytedance
Seedance 2.0 Mini
Seedance 2.0 Miniは、APIXOが提供するByteDance Seedance 2.0のワークフロー向けの低コストなモデルです。テキストから動画生成、最初と最後のフレーム指定、オムニリファレンスモードが利用でき、オプションで音声、ウェブ検索、480p/720pの出力に対応しています。
Alibaba
Wan 2.6 Image
Wan 2.6 Imageは、Alibabaが開発したtext-to-imageおよびimage-to-imageモデルです。プロンプト、ネガティブプロンプト、アスペクト比、バッチ数、およびオプションのシード制御に対応しています。
Alibaba
Wan 2.5 Image
Wan 2.5 Imageは、Alibabaが開発したバッチ処理に適した画像生成モデルです。text-to-imageおよびimage-to-imageのワークフローに対応しており、デフォルトではリクエストごとに4つの画像を生成します。
APIXO
Image Upscaler
イメージアップスケーラーは、APIXOの単一画像高画質化APIで、2K、4K、8Kのアップスケーリングと、JPG、PNG、WEBPの出力形式制御に対応しています。
APIXO
Image Watermark Remover
「イメージウォーターマークリムーバー」は、APIXO公認の単一画像クリーンアップAPIです。お客様が所有、または処理する許可を得ている画像から、サンプルマークやオーバーレイを除去します。
kling
Kling 3.0 Turbo
Kling 3.0 Turboは、Kuaishouの高速動画生成モデルです。テキストから動画、および単一画像から動画へのワークフローに対応し、720p/1080pの出力で3-15秒のクリップを生成します。
MiniMax
MiniMax Image 01
MiniMax Image 01は、MiniMax社のtext-to-imageおよびimage-to-imageモデルで、プロンプト最適化、柔軟なサイズ制御、1K/2Kプリセットを備え、タスクごとに最大9枚の画像を生成できます。
MiniMax
MiniMax Speech 2.8
MiniMax Speech 2.8は非同期のテキスト読み上げAPIです。HD・ターボ品質モード、プリセット音声、カスタムMiniMax voice_id対応、感情制御、発音辞書、多言語出力設定といった機能を搭載しています。
MiniMax
MiniMax Voice
MiniMax Voiceは、テキストによる音声デザインまたは単一の公開参照オーディオクリップから再利用可能なカスタムvoice IDを作成し、検証用のプレビュー音声を返します。
hailuo
Hailuo 2.3
Hailuo 2.3は、テキスト動画生成と画像動画生成に対応したMiniMax社の非同期動画モデルです。Standardモードは768pで6秒/10秒の出力をサポートし、Proモードは1080pで5秒固定の出力を返します。
hailuo
Hailuo 2.3 Fast
Hailuo 2.3 Fastは、MiniMax社の速度を最適化した画像動画生成モデルで、StandardモードとProモードがあります。Standardモードは768pで6秒/10秒の出力をサポートし、Proモードは1080pで6秒固定の出力を返します。
xai
Grok Image
Grok Imageは、text-to-imageおよびimage-to-imageのワークフローに対応したxAIの画像生成モデルです。シンプルなアスペクト比コントロールと非同期タスク配信機能を備えています。APIXOでは、text-to-imageはリクエストごとに6枚の画像を返します。
Alibaba
Wan 2.2 Animate
「Wan 2.2 Animate API」は、1つのソース画像と1つのモーションビデオを組み合わせて、animate/replaceの動作で様式化されたアニメーションを生成する、Alibabaのキャラクターアニメーションモデルです。
xai
Grok Video
Grok Videoは、テキストから動画、画像から動画へのワークフローに対応した、xAIの非同期型動画生成モデルです。オプションでtask_id + indexによる継続処理やスタイル制御が可能です。
kling
Kling 3.0 Std
Kling 3.0 Stdは、Kuaishouの標準品質の動画生成モデルで、「テキストから動画」、「画像から動画」、「モーションコントロール」の各モードを備えています。最大15秒のクリップをサポートし、オプションの音声生成と柔軟なアスペクト比に対応しています。
MeiGen
InfiniteTalk
InfiniteTalkは、1枚の写真と音声から、正確なリップシンクで話したり歌ったりするアバター動画を生成します。最大10分、解像度480pまたは720pに対応しています。
Nano Banana 2
Nano Banana 2は、1K/2K/4Kの出力制御、20,000文字のプロンプト、最大14枚の参照画像に対応した、Googleの高解像度画像生成モデルです。APIXOの現在のルートでは、Google検索コンテキストはアクティブな制御として公開されていません。
vidu
Vidu Q3
「Vidu Q3」は、標準およびTurboのtext-to-videoとimage-to-videoのワークフローを1つのAPIに統合した、秒単位で課金される動画生成モデルです。単一画像の動画化、最初と最後のフレーム間のトランジション、オプションのサウンドとBGMに対応し、最大1080pの出力が可能です。
kling
Kling 2.5 Turbo Pro
Kling 2.5 Turbo Proは、テキストや画像から動画を作成するためのKuaishouの高速動画モデルです。5-10秒のクリップ生成、オプションの最終フレーム画像、テキストからの動画生成におけるアスペクト比制御に加え、ネガティブプロンプトやCFGスケールガイダンスにも対応しています。
Lightricks
LTX-2 19B
LTX-2 19Bは、シネマティックな動画生成のためのLightricks製オープンソース19B拡散トランスフォーマーです。テキストから動画、画像から動画へのワークフロー、LoRAコンディショニングに対応し、APIでは最大1080pの高忠実度出力が可能です。
kling
Kling 2.1
Kling 2.1はKuaishouのマルチティア動画モデルで、「Standard」、「Pro」、「Master」の各モードで画像から動画、テキストから動画を生成します。5-10秒のクリップ生成に対応しているほか、「Pro」ではオプションで末尾画像を追加でき、「Master」のテキストから動画生成ではアスペクト比の制御が可能です。
kling
Kling 2.6
Kling 2.6は、動画、音声、効果音、環境音をワンパスで生成するKuaishouのネイティブ・オーディオビジュアル動画モデルです。中国語と英語の音声生成機能を備え、「テキストからオーディオビジュアル」および「画像からオーディオビジュアル」による最大10秒のクリップ作成をサポートします。
suno
Suno V6
Sunoの最新テキスト音楽生成モデル。キュー処理が高速になり、ボーカルはより豊かになりました。1回の呼び出しで、完成度の高い楽曲を2曲返します。
Claude
Claude Opus 4.8
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Claude
Claude Opus 4.7
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Claude
Claude Opus 4.6
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Claude
Claude Opus 4.5 20251101
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Claude
Claude Sonnet 4.6
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Claude
Claude Sonnet 4.5
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Claude
Claude Sonnet 4.5 20250929
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Claude
Claude Haiku 4.5 20251001
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.6 Sol
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.6 Terra
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.6 Luna
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.5
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.4
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.4 Mini
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.3-Codex
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.2
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5.2-Codex
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-5 Mini
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
OpenAI
GPT-6 Astra
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Gemini
Gemini 3.6 Flash
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Gemini
Gemini 3.5 Flash
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Gemini
Gemini 3.1 Pro Preview
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Gemini
Gemini 3 Flash Preview
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Gemini
Gemini 2.5 Pro
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Gemini
Gemini 3.7 Flash
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Gemini
Gemini 3.8 Flash
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Grok
Grok 4.5
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
Grok
Grok 4.6
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
APIXO
APIXO Spicy Chat
チャット、エージェント、推論、構造化生成に対応したOpenAI互換ゲートウェイ。
kling
Kling 4.0
Kling 4.0は、テキスト、順序指定キーフレーム、参照画像・動画、名前付きの被写体、音声から動画を生成します。
APIXO
Qwen Image Edit LoRA
テキストプロンプトとビジュアルリファレンス(任意)を使用して、元画像の構図とサイズを維持したまま編集します。
Nano Banana 2.1
最大10枚の参照画像を使用して画像を生成・編集し、1K、2K、または4K枚の画像を出力します。
Black Forest Labs
FLUX 3 Image
テキストから画像を1枚生成、または最大10枚の参照画像を編集して1K、2K、または4K枚を出力します。
Alibaba
Wan 3.0 Video LoRA
「Wan 3.0 Video LoRA」は、スマートデュレーション機能を備え、テキストから動画、画像から動画、参照から動画のワークフローをサポートします。参照モードでは、画像、動画、音声の入力に対応しています。
Alibaba
Wan 3.0 Video Pro LoRA
「Wan 3.0 Video Pro LoRA」は、テキストから動画、画像から動画、参照から動画のワークフローにおいて、出力の上限を4Kに引き上げます。スマートデュレーション機能のほか、画像、動画、音声をリファレンスとして使用することも可能です。
Black Forest Labs
FLUX 3
FLUX 3はBlack Forest Labs社のマルチモーダル動画モデルです。テキストからの動画生成、画像からの動画生成、動画拡張に対応し、ネイティブオーディオ付きで720pまたは1080pのMP4動画を出力します。
xai
Grok Imagine Video 1.5
Grok Imagine Video 1.5は、リファレンス画像、始点・終点フレーム、タイム指定キーフレーム、ループ画像をアニメーション化します。なお、入力制限は解像度によって異なります。
Alibaba
Wan 3.0 Video
Wan 3.0 Videoは、スマートデュレーション機能を備え、テキストから動画、画像から動画、参照から動画へのワークフローに対応しています。参照モードでは、画像、動画、音声、ファイル、リンクの入力が可能です。
kling
Kling 3.0 Omni
Kling 3.0 Omniは、単一のエンドポイントで9つのモードを公開します。これは、「テキストから動画」、「画像から動画」、「参照から動画」の各ワークフローにわたるstandard、pro、4Kのティアで構成されます。
MiniMax
MiniMax H3 LoRA
MiniMax H3 LoRAは、MiniMax H3をLoRAスタイル化したバージョンで、480pと768pの出力に対応しています。参照画像、音声、動画を使用して、参照ベースの動画生成を調整できます。
Veo 3.1
Google DeepMindのアップグレード版AI動画モデル。lite、fast、qualityの各ルート、4/6/8秒の長さ制御、720p/1080p/4k出力、複数画像参照ワークフローを備えています。
Alibaba
Wan 2.5
「Wan 2.5」は、テキストから動画および画像から動画のワークフローに対応したアリババの動画生成モデルです。オプションの音声入力、480p/720p/1080p形式の出力、5秒または10秒のクリップ、プロンプト拡張に対応しています。
OpenAI
Sora 2
アーカイブ情報。Sora 2は現在APIXOではご利用いただけません。
seedream
Seedream 4.5
Seedream 4.5は、高品質な画像生成を実現する強力なtext-to-imageおよびimage-to-image AIモデルです。2Kと4Kの解像度に対応しています。