

36モデル
このファミリーには13社のプロバイダーがあります
Gemini Omni
Gemini OmniはGoogleのマルチモーダル動画生成モデルで、テキスト、参照画像、ソース動画、再利用可能なオーディオアセット、キャラクターアセットIDから動画を生成します。
bytedance
Seedance 2.0
Seedance 2.0は、テキスト動画変換(text-to-video)、開始・終了フレーム指定(first-and-last-frames)、オムニリファレンス(omni-reference)モードに対応したByteDanceのマルチモーダル動画モデルです。APIXO限定:同時実行数無制限、実在人物のポートレート対応、非公開機能。
bytedance
Seedance 2.0 Fast
Seedance 2.0 Fastは、ByteDance Seedance 2.0のワークフローに対応するAPIXOルートです。テキスト動画変換(text-to-video)、開始・終了フレーム指定(first-and-last-frames)、オムニリファレンス(omni-reference)モードを公開し、オプションで音声、ウェブ検索、480p/720p出力に対応します。
Alibaba
HappyHorse
HappyHorseは、テキスト動画生成、画像動画生成、参照ベースの生成、動画編集の各ワークフローに対応するAlibaba社の動画生成・編集モデルです。720p/1080pの出力に対応しています。
bytedance
Seedance 2.5
Seedance 2.5は、参照ベースのより長いストーリーテリングを目的とした、ByteDanceの視聴覚動画モデルです。タイムラインベースのディレクション、マルチモーダルなクリエイティブガイダンス、同期された音声、多言語対応、部分的な修正機能を組み合わせることで、制作チームは個別の短いクリップではなく、つながりのあるシーンを開発できます。
MiniMax
MiniMax H3
MiniMax H3は、テキスト、画像、動画、音声のコンテキストを1つの生成ワークフローに統合する汎用マルチモーダル動画モデルです。ネイティブのステレオサウンド付きで最大2K、最長15秒の動画を作成できるほか、開始・最終フレームの制御、複合メディア参照、モーショントランスファー、マルチショットストーリーテリング、指示に基づく動画編集にも対応しています。
bytedance
Seedance 1.5 Pro
Seedance 1.5 Proは、ByteDanceの秒単位動画モデルで、高速なテキストから動画生成と画像から動画生成を実現します。480p/720p/1080pの出力、オプションの音声、アスペクト比の制御、固定レンズカメラの安定性に対応しています。
Alibaba
Wan 2.7
「Wan 2.7」は、テキストから動画、画像から動画、参照ガイド付き生成、動画編集の各ワークフローに対応した、アリババの動画生成および編集モデルです。オプションの音声入力と720p/1080pの出力に対応しています。
Alibaba
Wan 2.6
「Wan 2.6」は、テキスト、画像、フラッシュ画像、参照、フラッシュ参照の各ワークフローに対応した、アリババのマルチモーダル動画生成モデルです。オプションの音声入力と、720p/1080pの出力に対応しています。
OpenAI
Sora 2 Pro
アーカイブ情報。Sora 2 Proは現在APIXOではご利用いただけません。
APIXO
Video Upscaler
「動画アップスケーラー」は、ソース動画を1080p、2K、または4Kに高画質化するAPIXOのvideo-to-video APIで、ソース動画の秒単位で課金されます。
APIXO
Video Watermark Remover
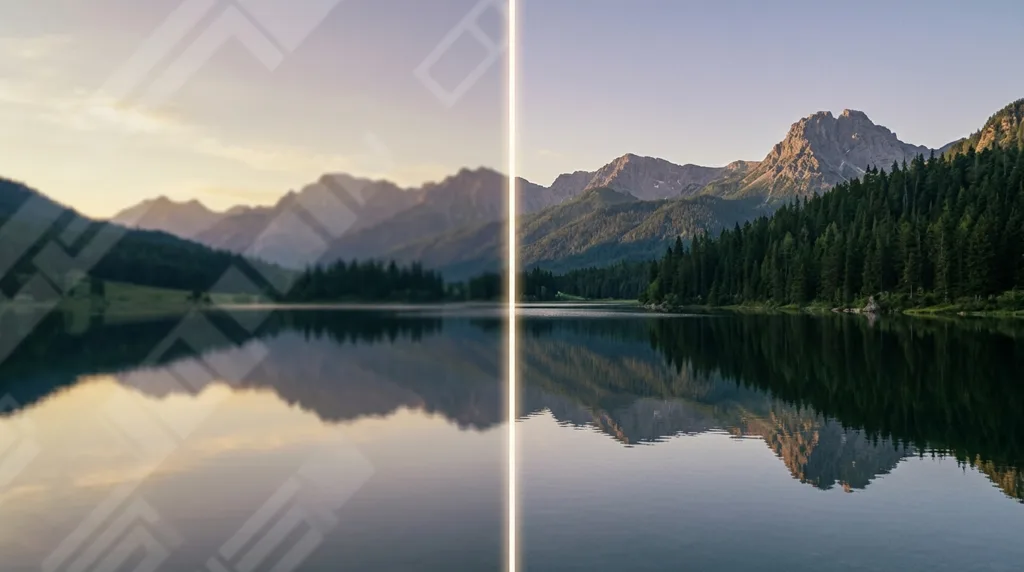
「動画ウォーターマーク除去」は、お客様が所有または変更する許可を得ている動画から、表示されているウォーターマーク、ロゴ、テキストオーバーレイを除去するための、APIXOのvideo-to-videoクリーンアップAPIです。ソース動画の秒単位で課金されます。
bytedance
Seedance 2.0 Mini
Seedance 2.0 Miniは、APIXOが提供するByteDance Seedance 2.0のワークフロー向けの低コストなモデルです。テキストから動画生成、最初と最後のフレーム指定、オムニリファレンスモードが利用でき、オプションで音声、ウェブ検索、480p/720pの出力に対応しています。
kling
Kling 3.0 Turbo
Kling 3.0 Turboは、Kuaishouの高速動画生成モデルです。テキストから動画、および単一画像から動画へのワークフローに対応し、720p/1080pの出力で3-15秒のクリップを生成します。
hailuo
Hailuo 2.3
Hailuo 2.3は、テキスト動画生成と画像動画生成に対応したMiniMax社の非同期動画モデルです。Standardモードは768pで6秒/10秒の出力をサポートし、Proモードは1080pで5秒固定の出力を返します。
hailuo
Hailuo 2.3 Fast
Hailuo 2.3 Fastは、MiniMax社の速度を最適化した画像動画生成モデルで、StandardモードとProモードがあります。Standardモードは768pで6秒/10秒の出力をサポートし、Proモードは1080pで6秒固定の出力を返します。
xai
Grok Imagine Video
Grok Imagine Videoは、テキストから動画、画像から動画へのワークフローに対応した、xAIの非同期型動画生成モデルです。オプションでtask_id + indexによる継続処理やスタイル制御が可能です。
Alibaba
Wan 2.2 Animate
「Wan 2.2 Animate API」は、1つのソース画像と1つのモーションビデオを組み合わせて、animate/replaceの動作で様式化されたアニメーションを生成する、Alibabaのキャラクターアニメーションモデルです。
MeiGen
InfiniteTalk
InfiniteTalkは、1枚の写真と音声から、正確なリップシンクで話したり歌ったりするアバター動画を生成します。最大10分、解像度480pまたは720pに対応しています。
kling
Kling 3.0 Std
Kling 3.0 Stdは、Kuaishouの標準品質の動画生成モデルで、「テキストから動画」、「画像から動画」、「モーションコントロール」の各モードを備えています。最大15秒のクリップをサポートし、オプションの音声生成と柔軟なアスペクト比に対応しています。
vidu
Vidu Q3
「Vidu Q3」は、標準およびTurboのtext-to-videoとimage-to-videoのワークフローを1つのAPIに統合した、秒単位で課金される動画生成モデルです。単一画像の動画化、最初と最後のフレーム間のトランジション、オプションのサウンドとBGMに対応し、最大1080pの出力が可能です。
kling
Kling 2.5 Turbo Pro
Kling 2.5 Turbo Proは、テキストや画像から動画を作成するためのKuaishouの高速動画モデルです。5-10秒のクリップ生成、オプションの最終フレーム画像、テキストからの動画生成におけるアスペクト比制御に加え、ネガティブプロンプトやCFGスケールガイダンスにも対応しています。
Lightricks
LTX-2 19B
LTX-2 19Bは、シネマティックな動画生成のためのLightricks製オープンソース19B拡散トランスフォーマーです。テキストから動画、画像から動画へのワークフロー、LoRAコンディショニングに対応し、APIでは最大1080pの高忠実度出力が可能です。
kling
Kling 2.1
Kling 2.1はKuaishouのマルチティア動画モデルで、「Standard」、「Pro」、「Master」の各モードで画像から動画、テキストから動画を生成します。5-10秒のクリップ生成に対応しているほか、「Pro」ではオプションで末尾画像を追加でき、「Master」のテキストから動画生成ではアスペクト比の制御が可能です。
kling
Kling 2.6
Kling 2.6は、動画、音声、効果音、環境音をワンパスで生成するKuaishouのネイティブ・オーディオビジュアル動画モデルです。中国語と英語の音声生成機能を備え、「テキストからオーディオビジュアル」および「画像からオーディオビジュアル」による最大10秒のクリップ作成をサポートします。
Veo 3.1
Google DeepMindのアップグレード版AI動画モデル。lite、fast、qualityの各ルート、4/6/8秒の長さ制御、720p/1080p/4k出力、複数画像参照ワークフローを備えています。
Alibaba
Wan 2.5
「Wan 2.5」は、テキストから動画および画像から動画のワークフローに対応したアリババの動画生成モデルです。オプションの音声入力、480p/720p/1080p形式の出力、5秒または10秒のクリップ、プロンプト拡張に対応しています。
OpenAI
Sora 2
アーカイブ情報。Sora 2は現在APIXOではご利用いただけません。
kling
Kling 4.0
Kling 4.0は、テキスト、順序指定キーフレーム、参照画像・動画、名前付きの被写体、音声から動画を生成します。
Alibaba
Wan 3.0 Video LoRA
「Wan 3.0 Video LoRA」は、スマートデュレーション機能を備え、テキストから動画、画像から動画、参照から動画のワークフローをサポートします。参照モードでは、画像、動画、音声の入力に対応しています。
Alibaba
Wan 3.0 Video Pro LoRA
「Wan 3.0 Video Pro LoRA」は、テキストから動画、画像から動画、参照から動画のワークフローにおいて、出力の上限を4Kに引き上げます。スマートデュレーション機能のほか、画像、動画、音声をリファレンスとして使用することも可能です。
Black Forest Labs
FLUX 3
FLUX 3はBlack Forest Labs社のマルチモーダル動画モデルです。テキストからの動画生成、画像からの動画生成、動画拡張に対応し、ネイティブオーディオ付きで720pまたは1080pのMP4動画を出力します。
xai
Grok Imagine Video 1.5
Grok Imagine Video 1.5は、リファレンス画像、始点・終点フレーム、タイム指定キーフレーム、ループ画像をアニメーション化します。なお、入力制限は解像度によって異なります。
kling
Kling 3.0 Omni
Kling 3.0 Omniは、単一のエンドポイントで9つのモードを公開します。これは、「テキストから動画」、「画像から動画」、「参照から動画」の各ワークフローにわたるstandard、pro、4Kのティアで構成されます。
MiniMax
MiniMax H3 LoRA
MiniMax H3 LoRAは、MiniMax H3をLoRAスタイル化したバージョンで、480pと768pの出力に対応しています。参照画像、音声、動画を使用して、参照ベースの動画生成を調整できます。
Alibaba
Wan 3.0 Video
Wan 3.0 Videoは、スマートデュレーション機能を備え、テキストから動画、画像から動画、参照から動画へのワークフローに対応しています。参照モードでは、画像、動画、音声、ファイル、リンクの入力が可能です。