

Modellkatalog
Neueste und beliebte Modelle
Beginnen Sie mit den Modellen, die zuerst ausprobiert werden, und durchsuchen und filtern Sie dann den gesamten Katalog nach Ausgabetyp oder Workflow.
Modelltyp
Workflow
96 Modelle
Der gesamte Katalog wird angezeigt
bytedance
Seedance 2.0
Seedance 2.0 ist das multimodale Videomodell von ByteDance, das die Modi Text-zu-Video, Erste-und-letzte-Frames sowie Omni-Referenz unterstützt. Exklusiv bei APIXO: unbegrenzte Parallelität, Unterstützung für Porträts von realen Personen und versteckte Funktionen.
bytedance
Seedance 2.0 Fast
Seedance 2.0 Fast ist eine APIXO-Route für ByteDance Seedance 2.0-Workflows, die Modi für Text-zu-Video, erste und letzte Frames sowie Omni-Referenz mit optionalem Ton, Websuche und einer 480p/720p-Ausgabe bereitstellt.
OpenAI
GPT-Image-2
GPT-Image-2 ist das Bildmodell der nächsten Generation von OpenAI für stärkeren Fotorealismus, sauberere Bildbearbeitung und schärfere Textwiedergabe im Bild.
Alibaba
HappyHorse
HappyHorse ist Alibabas Modell zur Videogenerierung und -bearbeitung für Text-zu-Video-, Bild-zu-Video-, referenzgesteuerte Generierungs- und Videobearbeitungs-Workflows mit einer 720p/1080p-Ausgabe.
Black Forest Labs
Flux 2
BFLs neueste Pro & Flex-Pipelines für Text-zu-Bild und Bild-zu-Bild mit einheitlicher 1K/2K-Preisgestaltung und Generierung in ca. 30s.
Nano Banana Pro
Nano Banana Pro ist Googles Gemini 3 Pro Image-Route für schlussfolgerungsgestützte Bilderzeugung, native 4K-Ausgabe, mehrsprachige Typografie und räumlich präzise Kompositionen. APIXO stellt Search Grounding auf dieser Route nicht als aktive Steuerung bereit.
midjourney
Midjourney
Midjourney ist ein fortschrittliches KI-Bilderzeugungsmodell, das für seine künstlerischen, qualitativ hochwertigen Ergebnisse bekannt ist. Es unterstützt Text-zu-Bild-, Bild-zu-Bild-, Bildbearbeitungs-, Vary- und Upscale-Workflows.
Black Forest Labs
Flux Kontext
Bilderzeugung in Profi-Qualität mit verbessertem Prompt-Verständnis und überragender Ausgabequalität.
OpenAI
GPT-Image-1
GPT-Image-1 ist das fortschrittliche multimodale Modell von OpenAI für die Generierung hochwertiger Bilder mit natürlichem Sprachverständnis.
Nano Banana
Gemini 2.5 Flash Image Preview (auch bekannt als Nano Banana) ist ein fortschrittliches KI-Modell, das sich durch sprachgesteuerte Bilderzeugung und -bearbeitung auszeichnet. Es erzeugt hyperrealistische, physikbasierte Visualisierungen mit nahtlosen Stiltransformationen.
OpenAI
GPT-Image-2.5
Erstellen und verfeinern Sie Bilder mit GPT Image 2.5. Verwandeln Sie ein schriftliches Briefing oder ein Referenzfoto in Produktvisualisierungen, Porträts sowie Illustrationen und passen Sie anschließend die wichtigen Details an.
bytedance
Seedance 2.5
Seedance 2.5 ist das audiovisuelle Videomodell von ByteDance für längeres, referenzgesteuertes Storytelling. Es kombiniert zeitleistenbasierte Regie, multimodale kreative Anleitung, synchronisierten Ton, mehrsprachige Performance und selektive Überarbeitung, um Produktionsteams bei der Entwicklung zusammenhängender Szenen anstelle von isolierten kurzen Clips zu unterstützen.
Alibaba
Qwen Image 3.0
Qwen Image 3.0 ist Alibabas Text-zu-Bild- und Bild-zu-Bild-Modell mit 1K- und 2K-Ausgabe, fünfzehn Seitenverhältnissen, bis zu drei Referenzbildern und optionaler Prompt-Erweiterung. Beide Auflösungsstufen werden zum gleichen Tarif abgerechnet.
Alibaba
Qwen Image 3.0 Pro
Qwen Image 3.0 Pro ist Alibabas höherstufige Variante für denselben Text-zu-Bild- und Bild-zu-Bild-Vertrag, die die 1K- und 2K-Ausgabe separat bepreist, sodass Entwürfe und finale Ergebnisse unterschiedlich abgerechnet werden können.
MiniMax
MiniMax H3
MiniMax H3 ist ein multimodales Allzweck-Videomodell, das Text-, Bild-, Video- und Audiokontext in einem einzigen Generierungs-Workflow kombiniert. Es erstellt Videos von bis zu 2K und 15 Sekunden Länge mit nativem Stereoton und unterstützt dabei die Steuerung des ersten und letzten Frames, Mixed-Media-Referenzen, Bewegungsübertragung, Multi-Shot-Storytelling sowie anweisungsgesteuerte Videobearbeitung.
seedream
Seedream 5.0 Pro
Seedream 5.0 Pro ist das Premium-Einzelbildmodell von ByteDance für die Text-zu-Bild- und Bild-zu-Bild-Generierung, das eine Auflösung von 1K/2K, acht Seitenverhältnisse, bis zu 10 Referenzbilder und eine strikte Steuerung der benutzerdefinierten Größe unterstützt.
bytedance
Seedance 1.5 Pro
Seedance 1.5 Pro ist das Videomodell von ByteDance mit sekundengenauer Abrechnung für die schnelle Generierung von Text-zu-Video und Bild-zu-Video mit 480p/720p/1080p-Ausgabe, optionalem Ton, Steuerung des Seitenverhältnisses und Stabilität einer Kamera mit fester Brennweite.
Gemini Omni
Gemini Omni ist das multimodale Videogenerierungsmodell von Google zur Erstellung von Videos aus Text, Bildreferenzen, Quellvideos, wiederverwendbaren Audio-Assets und Charakter-Asset-IDs.
Alibaba
Wan 2.7 Image
Wan 2.7 Image ist Alibabas Omni-Image-API für Text-zu-Bild, referenzgestützte Bilderzeugung, Bildbearbeitung, Bildersequenzen und hochauflösende Omni Image Pro-Workflows.
Alibaba
Wan 2.7
Wan 2.7 ist Alibabas Modell zur Videogenerierung und -bearbeitung für Text-zu-Video-, Bild-zu-Video-, referenzgestützte Generierungs- und Videobearbeitungs-Workflows, mit optionaler Audioeingabe und 720p/1080p-Ausgabe.
Alibaba
Wan 2.6
Wan 2.6 ist Alibabas multimodales Videogenerierungsmodell für Text-, Bild-, Flash-Bild-, Referenz- und Flash-Referenz-Workflows, mit optionaler Audioeingabe und 720p/1080p-Ausgabe.
seedream
Seedream 5.0
Seedream 5.0 ist das KI-Bildmodell der nächsten Generation von ByteDance mit Echtzeit-Websuche, steuerbarer Bearbeitung und logischem Schlussfolgern. Es unterstützt die Text-zu-Bild- und Bild-zu-Bild-Generierung mit einer Auflösung von 2K/3K, mehreren Seitenverhältnissen und bis zu 14 Referenzbildern.
OpenAI
Sora 2 Pro
Archivierte Informationen. Sora 2 Pro ist auf APIXO nicht mehr verfügbar.
APIXO
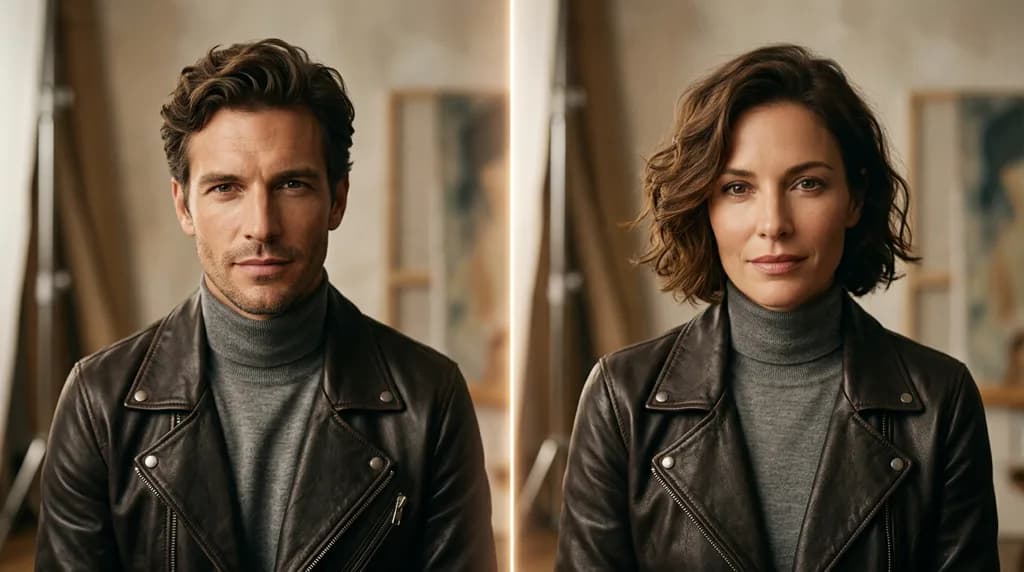
Face Swap
Gesichtstausch ist die Bild-zu-Bild-API von APIXO, die das Gesicht in einem Zielfoto durch das Gesicht aus einem Referenzfoto ersetzt, für Porträts, deren Eigentümer Sie sind oder zu deren Verwendung Sie autorisiert sind.
APIXO
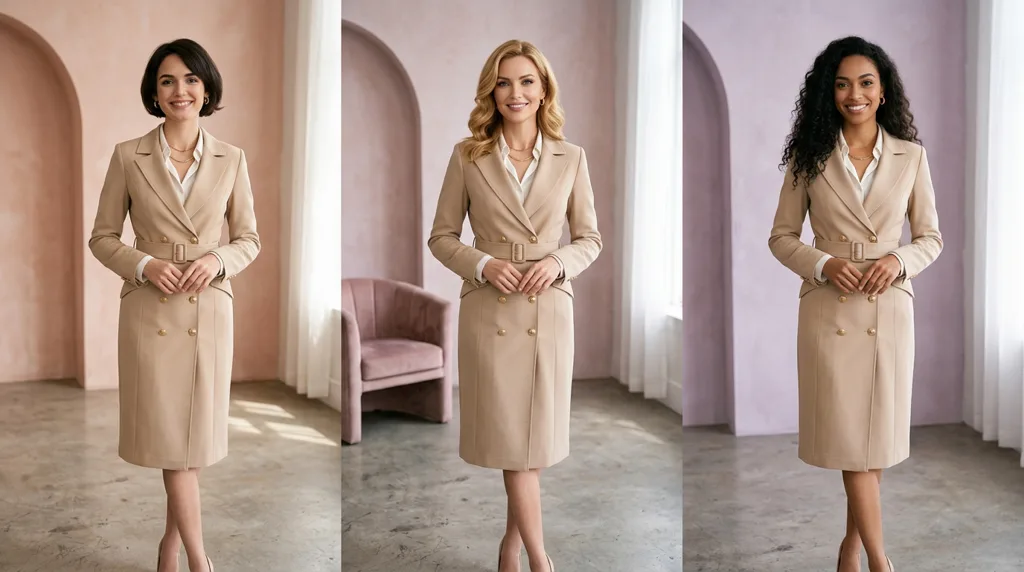
Head Swap
Kopfaustausch ist die Bild-zu-Bild-API von APIXO, die den gesamten Kopf in einem Zielfoto durch den Kopf aus einem Referenzfoto ersetzt, für Porträts, die Ihnen gehören oder zu deren Verwendung Sie berechtigt sind.
APIXO
Video Upscaler
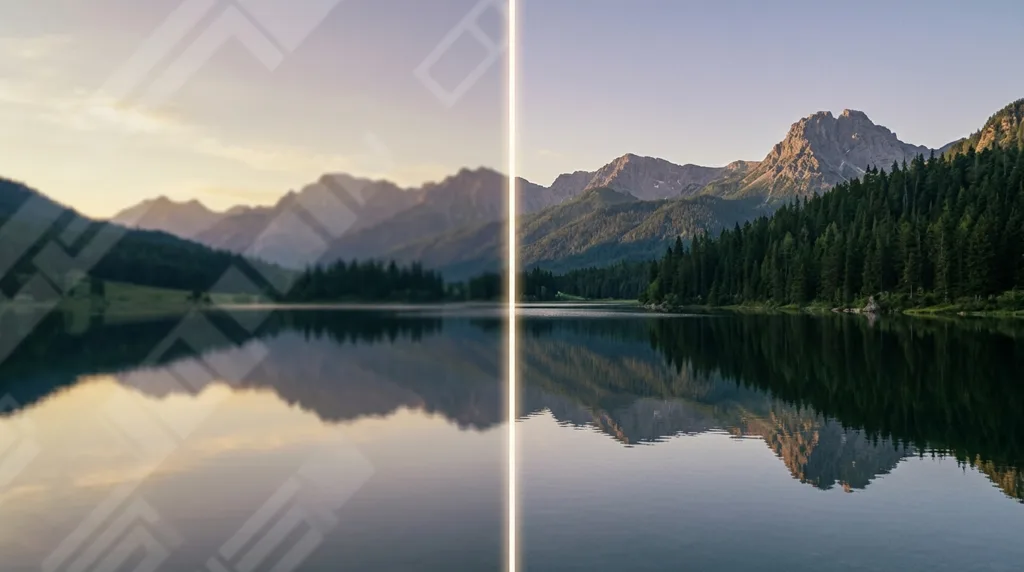
Der Video-Hochskalierer ist die Video-zu-Video-API von APIXO, die ein Quellvideo auf 1080p, 2K oder 4K hochskaliert, abgerechnet pro Sekunde des Quellvideos.
APIXO
Video Watermark Remover
Der Video-Wasserzeichenentferner ist die Video-zu-Video-Bereinigungs-API von APIXO zum Entfernen sichtbarer Wasserzeichen, Logos und Texteinblendungen aus einem Video, das Sie besitzen oder zu dessen Bearbeitung Sie berechtigt sind, abgerechnet pro Sekunde des Quellvideos.
APIXO
Z-Image LoRA Pro
Z-Image LoRA Pro ist eine asynchrone Text-zu-Bild-API, die für lebendige Details optimiert wurde. Sie gibt ein Bild pro Anfrage zurück und bietet Voreinstellungen für das Seitenverhältnis, exakte Pixelgrößen von bis zu 2560 pro Seite, Seed-Reproduzierbarkeit und eine Prompt-Erweiterung ohne zusätzliche Kosten.
APIXO
Z-Image LoRA
Z-Image LoRA ist eine asynchrone Text-zu-Bild-API, die ein Bild pro Anfrage zurückgibt, mit Voreinstellungen für das Seitenverhältnis, exakter Steuerung der Pixelgröße, Seed-Reproduzierbarkeit und Prompt-Erweiterung ohne zusätzliche Kosten.
bytedance
Seedance 2.0 Mini
Seedance 2.0 Mini ist eine kostengünstigere APIXO-Route für ByteDance Seedance 2.0-Workflows, die die Modi Text-zu-Video, Erste-und-letzte-Frames und Omni-Referenz mit optionalem Ton, Websuche und 480p/720p-Ausgabe bereitstellt.
Alibaba
Wan 2.6 Image
Wan 2.6 Image ist Alibabas Text-zu-Bild- und Bild-zu-Bild-Modell mit Prompt, negativem Prompt, Seitenverhältnis, Batch-Anzahl und optionaler Seed-Kontrolle.
Alibaba
Wan 2.5 Image
Wan 2.5 Image ist Alibabas stapelverarbeitungsfreundliches Bilderzeugungsmodell für Text-zu-Bild- und Bild-zu-Bild-Workflows, das standardmäßig vier Bilder pro Anfrage generiert.
APIXO
Image Upscaler
Bild-Upscaler ist die API von APIXO zur Verbesserung einzelner Bilder für die 2K-, 4K- und 8K-fache Hochskalierung, mit Steuerung der Ausgabeformate JPG, PNG und WEBP.
APIXO
Image Watermark Remover
Der Wasserzeichen-Entferner für Bilder ist die autorisierte API von APIXO zur Bildbereinigung. Er entfernt Mustermarkierungen oder Überlagerungen von Bildern, deren Eigentümer Sie sind oder zu deren Verarbeitung Sie berechtigt sind.
kling
Kling 3.0 Turbo
Kling 3.0 Turbo ist Kuaishous schnelles Videogenerierungsmodell für Text-zu-Video- und Einzelbild-Bild-zu-Video-Workflows mit einer Ausgabe von 720p/1080p und 3-15 Sekunden langen Clips.
MiniMax
MiniMax Image 01
MiniMax Image 01 ist das Text-zu-Bild- und Bild-zu-Bild-Modell von MiniMax mit Prompt-Optimierung, flexibler Größensteuerung, 1K/2K-Voreinstellungen und bis zu 9 generierten Bildern pro Aufgabe.
MiniMax
MiniMax Speech 2.8
MiniMax Speech 2.8 ist eine asynchrone Text-zu-Sprache-API mit HD- und Turbo-Qualitätsmodi, voreingestellten Stimmen, Unterstützung für benutzerdefinierte MiniMax-voice_ids, Emotionssteuerung, Aussprachewörterbüchern und mehrsprachigen Ausgabeeinstellungen.
MiniMax
MiniMax Voice
MiniMax Voice erstellt wiederverwendbare, benutzerdefinierte Sprach-IDs aus einem per Text beschriebenen Stimmendesign oder einem einzelnen öffentlichen Referenz-Audioclip und gibt anschließend eine Audiovorschau zur Validierung zurück.
hailuo
Hailuo 2.3
Hailuo 2.3 ist das asynchrone Videomodell von MiniMax mit Standard- und Pro-Modi für die Text-zu-Video- und Bild-zu-Video-Generierung. Der Standardmodus unterstützt 6s/10s bei 768p, während der Pro-Modus eine feste 5s-Ausgabe bei 1080p liefert.
hailuo
Hailuo 2.3 Fast
Hailuo 2.3 Fast ist das geschwindigkeitsoptimierte Bild-zu-Video-Modell von MiniMax mit Standard- und Pro-Modi. Der Standardmodus unterstützt 6s/10s bei 768p, während der Pro-Modus eine feste 6s-Ausgabe bei 1080p liefert.
xai
Grok Image
Grok Image ist das Bildgenerierungsmodell von xAI für Text-zu-Bild- und Bild-zu-Bild-Workflows mit einfacher Steuerung des Seitenverhältnisses und asynchroner Aufgabenbereitstellung. Text-zu-Bild liefert auf APIXO 6 Bilder pro Anfrage.
Alibaba
Wan 2.2 Animate
Die Wan 2.2 Animate API ist ein Charakteranimationsmodell von Alibaba, das ein Quellbild und ein Bewegungsvideo kombiniert, um stilisierte, animierte Ausgaben mit Animations-/Ersetzungsverhalten zu generieren.
xai
Grok Video
Grok Video ist das asynchrone Videogenerierungsmodell von xAI für Text-zu-Video- und Bild-zu-Video-Workflows, mit optionaler Fortsetzung über task_id + Index und Stilsteuerung.
kling
Kling 3.0 Std
Kling 3.0 Std ist das Videogenerierungsmodell von Kuaishou in Standardqualität mit Modi für Text-zu-Video, Bild-zu-Video und Bewegungssteuerung. Es unterstützt Clips mit einer Länge von bis zu 15 Sekunden, optionale Tongenerierung und flexible Seitenverhältnisse.
MeiGen
InfiniteTalk
InfiniteTalk wandelt ein Foto plus Audio in audiodatengesteuerte sprechende oder singende Avatar-Videos mit präziser Lippensynchronisation um. Unterstützt bis zu 10 Minuten bei einer Auflösung von 480p oder 720p.
Nano Banana 2
Nano Banana 2 ist Googles hochauflösendes Modell zur Bilderzeugung mit 1K/2K/4K-Ausgabesteuerung, Prompts mit 20,000 Zeichen und Unterstützung für bis zu 14 Referenzbilder. Der Google-Suchkontext wird in der aktuellen Route von APIXO nicht als aktive Steuerung bereitgestellt.
vidu
Vidu Q3
Vidu Q3 ist ein Modell zur Videogenerierung mit sekundengenauer Abrechnung, das Standard- und Turbo-Workflows für Text-zu-Video sowie Bild-zu-Video in einer einzigen API kombiniert. Es unterstützt Einzelbildanimation, Übergänge zwischen dem ersten und letzten Frame, optionalen Ton und BGM sowie eine Ausgabe von bis zu 1080p.
kling
Kling 2.5 Turbo Pro
Kling 2.5 Turbo Pro ist das Hochgeschwindigkeits-Videomodell von Kuaishou für die Erstellung von Text-zu-Video und Bild-zu-Video. Es unterstützt 5-10 Sekunden lange Clips, optionale Endbilder, die Steuerung des Seitenverhältnisses für Text-zu-Video sowie negative Prompts und eine Anleitung zur CFG-Skalierung.
Lightricks
LTX-2 19B
LTX-2 19B ist ein Open-Source-19B-Diffusions-Transformer von Lightricks für die Generierung kinoreifer Videos. Es unterstützt Text-zu-Video- und Bild-zu-Video-Workflows, LoRA-Konditionierung und High-Fidelity-Ausgaben mit bis zu 1080p in der API.
kling
Kling 2.1
Kling 2.1 ist Kuaishous mehrstufiges Videomodell mit den Modi Standard, Pro und Master für die Bild-zu-Video- und Text-zu-Video-Erstellung. Es unterstützt 5-10-Sekunden-Clips, optionale Endbilder für Pro und die Steuerung des Seitenverhältnisses für Master-Text-zu-Video.
kling
Kling 2.6
Kling 2.6 ist Kuaishous natives audiovisuelles Videomodell, das in einem einzigen Durchgang Video, Sprache, Soundeffekte und Umgebungsgeräusche generiert. Es unterstützt die Text-to-Audio-Visual- und Image-to-Audio-Visual-Erstellung mit chinesischer und englischer Stimmerzeugung und Clips von bis zu 10 Sekunden.
suno
Suno V6
Neuestes Suno Text-zu-Musik-Modell, das pro Aufruf zwei ausgefeilte Songs mit schnelleren Warteschlangen und volleren Vocals zurückgibt.
Claude
Claude Opus 4.8
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Claude
Claude Opus 4.7
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Claude
Claude Opus 4.6
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Claude
Claude Opus 4.5 20251101
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Claude
Claude Sonnet 4.6
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Claude
Claude Sonnet 4.5
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Claude
Claude Sonnet 4.5 20250929
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Claude
Claude Haiku 4.5 20251001
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.6 Sol
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.6 Terra
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.6 Luna
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.5
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.4
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.4 Mini
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.3-Codex
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.2
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5.2-Codex
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-5 Mini
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
OpenAI
GPT-6 Astra
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Gemini
Gemini 3.6 Flash
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Gemini
Gemini 3.5 Flash
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Gemini
Gemini 3.1 Pro Preview
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Gemini
Gemini 3 Flash Preview
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Gemini
Gemini 2.5 Pro
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Gemini
Gemini 3.7 Flash
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Gemini
Gemini 3.8 Flash
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Grok
Grok 4.5
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
Grok
Grok 4.6
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
APIXO
APIXO Spicy Chat
OpenAI-kompatibles Gateway für Chat, Agenten, Reasoning und strukturierte Erstellung.
kling
Kling 4.0
Kling 4.0 generiert Videos aus Text, geordneten Keyframes, Referenzbildern und -videos, benannten Subjekten und Stimmen.
APIXO
Qwen Image Edit LoRA
Bearbeiten Sie ein Hauptbild mit einer Texteingabe und optionalen visuellen Referenzen und behalten Sie dabei dessen Komposition und Abmessungen bei.
Nano Banana 2.1
Generieren und bearbeiten Sie Bilder mit bis zu 10 Referenzen und 1K, 2K oder 4K Ausgaben.
Black Forest Labs
FLUX 3 Image
Generieren Sie ein Bild aus Text oder bearbeiten Sie bis zu 10 Referenzbilder mit 1K, 2K oder 4K Ausgabe.
Alibaba
Wan 3.0 Video LoRA
Wan 3.0 Video LoRA unterstützt Text-zu-Video-, Bild-zu-Video- und Referenz-zu-Video-Workflows mit intelligenter Dauer. Der Referenzmodus akzeptiert Bild-, Video- und Audioeingaben.
Alibaba
Wan 3.0 Video Pro LoRA
Wan 3.0 Video Pro LoRA erhöht die Ausgabeobergrenze auf 4K bei Text-zu-Video-, Bild-zu-Video- und Referenz-zu-Video-Workflows, mit intelligenter Dauer und Bild-, Video- und Audio-Referenzen.
Black Forest Labs
FLUX 3
FLUX 3 ist das multimodale Videomodell von Black Forest Labs für Text-zu-Video, Bild-zu-Video und Videoerweiterung mit nativer Audioausgabe sowie MP4-Ausgabe in 720p oder 1080p.
xai
Grok Imagine Video 1.5
Grok Imagine Video 1.5 animiert Referenzbilder, erste und letzte Frames, zeitgesteuerte Keyframes sowie Loop-Bilder mit auflösungsabhängigen Eingabebeschränkungen.
Alibaba
Wan 3.0 Video
Wan 3.0 Video unterstützt Text-zu-Video-, Bild-zu-Video- und Referenz-zu-Video-Workflows mit intelligenter Dauer. Der Referenzmodus akzeptiert Bild-, Video-, Audio-, Datei- und Link-Eingaben.
kling
Kling 3.0 Omni
Kling 3.0 Omni stellt über einen einzigen Endpunkt neun Modi bereit: die Stufen Standard, Pro und 4K für die Workflows Text-to-Video, Image-to-Video und Reference-to-Video.
MiniMax
MiniMax H3 LoRA
MiniMax H3 LoRA ist die LoRA-stilisierte Version von MiniMax H3 mit 480p- und 768p-Ausgabe. Referenzbilder, Audio und Video können die Reference-to-Video-Generierung konditionieren.
Veo 3.1
Verbessertes KI-Videomodell von Google DeepMind mit Lite-, Fast- und Quality-Routen, Dauersteuerung für 4/6/8 Sekunden, Ausgabe in 720p/1080p/4k und Multi-Bild-Referenz-Workflows.
Alibaba
Wan 2.5
Wan 2.5 ist Alibabas Videogenerierungsmodell für Text-zu-Video- und Bild-zu-Video-Workflows, mit optionaler Audioeingabe, 480p/720p/1080p-Ausgabe, 5- oder 10-sekündigen Clips und Prompterweiterung.
OpenAI
Sora 2
Archivierte Informationen. Sora 2 ist auf APIXO nicht mehr verfügbar.
seedream
Seedream 4.5
Seedream 4.5 ist ein leistungsstarkes KI-Modell für die Text-zu-Bild- und Bild-zu-Bild-Generierung, das eine hochwertige Bildgenerierung mit Unterstützung für die Auflösungen 2K und 4K liefert.