

Catalogue de modèles
Modèles les plus récents et populaires
Commencez avec les modèles les plus populaires, puis recherchez et filtrez le catalogue complet par type de sortie ou workflow.
Type de modèle
Flux de travail
96 modèles
Affichage du catalogue complet
bytedance
Seedance 2.0
Seedance 2.0 est le modèle vidéo multimodal de ByteDance, prenant en charge les modes texte-vidéo, première et dernière image, et omni-référence. En exclusivité sur APIXO : concurrence illimitée, prise en charge des portraits de personnes réelles et fonctionnalités cachées.
bytedance
Seedance 2.0 Fast
Seedance 2.0 Fast est une route APIXO pour les workflows ByteDance Seedance 2.0, exposant les modes texte-vers-vidéo, première et dernière images et omni-référence, avec en option le son, la recherche web et une sortie 480p/720p.
OpenAI
GPT-Image-2
GPT-Image-2 est le modèle d'image nouvelle génération d'OpenAI, offrant un photoréalisme accru, une retouche d'image plus nette et un rendu du texte intégré plus précis.
Alibaba
HappyHorse
HappyHorse est le modèle de génération et d'édition vidéo d'Alibaba pour les workflows de conversion texte-vidéo, image-vidéo, de génération guidée par référence et d'édition vidéo, avec une sortie 720p/1080p.
Black Forest Labs
Flux 2
Les derniers pipelines Pro et Flex de BFL pour la génération de texte vers image et d'image vers image, avec une tarification unifiée 1K/2K et une génération en ~30s.
Nano Banana Pro
Nano Banana Pro est la route Gemini 3 Pro Image de Google pour la génération d'images basée sur le raisonnement, la sortie native en 4K, la typographie multilingue et les compositions spatialement précises. APIXO n'expose pas Search Grounding en tant que commande active sur cette route.
midjourney
Midjourney
Midjourney est un modèle de génération d'images par AI avancé, réputé pour ses résultats artistiques de haute qualité. Il prend en charge les flux de travail text-to-image, image-to-image, image-edit, Vary et Upscale.
Black Forest Labs
Flux Kontext
Génération d'images de qualité professionnelle avec une compréhension améliorée des prompts et un rendu de qualité supérieure.
OpenAI
GPT-Image-1
GPT-Image-1 est le modèle multimodal avancé d'OpenAI, conçu pour la génération d'images haute qualité grâce à la compréhension du langage naturel.
Nano Banana
Gemini 2.5 Flash Image Preview (alias Nano Banana) est un modèle d'IA avancé spécialisé dans la génération et la retouche d'images à partir du langage naturel. Il produit des visuels hyperréalistes et physiquement cohérents, avec des transformations de style fluides.
OpenAI
GPT-Image-2.5
Créez et affinez des images avec GPT Image 2.5. Transformez un brief écrit ou une photo de référence en visuels de produits, portraits et illustrations, puis peaufinez les détails qui comptent.
bytedance
Seedance 2.5
Seedance 2.5 est le modèle vidéo audiovisuel de ByteDance pour les narrations plus longues guidées par des références. Il combine une réalisation basée sur une chronologie, un guidage créatif multimodal, un son synchronisé, des performances multilingues et la révision sélective pour aider les équipes de production à développer des scènes liées entre elles au lieu de clips courts et isolés.
Alibaba
Qwen Image 3.0
Qwen Image 3.0 est le modèle text-to-image et image-to-image d'Alibaba. Il propose des résolutions de 1K et 2K, quinze rapports d'aspect, jusqu'à trois images de référence et une extension de prompt facultative. Les deux niveaux de résolution sont facturés au même tarif.
Alibaba
Qwen Image 3.0 Pro
Qwen Image 3.0 Pro est la version supérieure d'Alibaba pour le même contrat text-to-image et image-to-image. Les rendus en 1K et 2K sont facturés séparément, ce qui permet une facturation distincte pour les ébauches et les livrables finaux.
MiniMax
MiniMax H3
MiniMax H3 est un modèle vidéo multimodal polyvalent qui combine du texte, des images, des vidéos et de l'audio dans un seul workflow de génération. Il crée des vidéos d'une durée maximale de 2K et 15 secondes avec un son stéréo natif, tout en prenant en charge le contrôle de la première et de la dernière image, les références multimédias, le transfert de mouvement, la narration multi-plans et le montage vidéo guidé par instructions.
seedream
Seedream 5.0 Pro
Seedream 5.0 Pro est le modèle premium de ByteDance pour la génération d'images uniques texte-image et image-image, prenant en charge une résolution de 1K/2K, huit formats d'image, jusqu'à 10 images de référence et un contrôle strict des tailles personnalisées.
bytedance
Seedance 1.5 Pro
Seedance 1.5 Pro est le modèle vidéo par seconde de ByteDance pour la génération rapide de type texte-vidéo et image-vidéo, avec une sortie 480p/720p/1080p, du son en option, un contrôle du format d'image et une stabilité de caméra à objectif fixe.
Gemini Omni
Gemini Omni est le modèle de génération de vidéo multimodal de Google, permettant de créer des vidéos à partir de texte, de références d'images, d'une vidéo source, de ressources audio réutilisables et d'ID de ressources de personnages.
Alibaba
Wan 2.7 Image
Wan 2.7 Image est l'API omni-image d'Alibaba pour la génération texte-image, la génération d'images guidée par référence, la retouche d'images, les images séquentielles et les flux de travail haute résolution Omni Image Pro.
Alibaba
Wan 2.7
Wan 2.7 est le modèle de génération et de montage vidéo d'Alibaba pour la génération texte-vers-vidéo et image-vers-vidéo, la génération guidée par référence et le montage vidéo, avec une entrée audio facultative et une sortie 720p/1080p.
Alibaba
Wan 2.6
Wan 2.6 est le modèle de génération de vidéo multimode d'Alibaba pour les flux de travail à partir de texte, d'image, d'image flash, de référence et de référence flash, avec une entrée audio en option et une sortie 720p/1080p.
seedream
Seedream 5.0
Seedream 5.0 est le modèle d'image IA nouvelle génération de ByteDance, doté de capacités de recherche web en temps réel, d'édition contrôlable et de raisonnement logique. Il prend en charge la génération texte-image et image-image avec une résolution de 2K/3K, plusieurs formats d'image et jusqu'à 14 images de référence.
OpenAI
Sora 2 Pro
Informations archivées. Sora 2 Pro n'est plus disponible sur APIXO.
APIXO
Face Swap
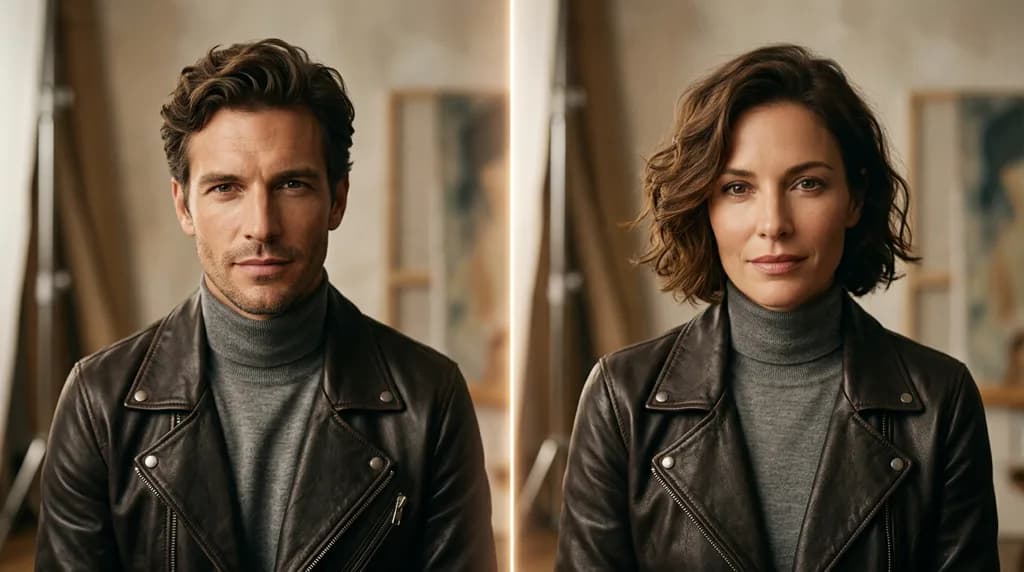
Échange de visage est l'API image-to-image d'APIXO qui remplace le visage d'une photo cible par celui d'une photo de référence, pour des portraits qui vous appartiennent ou que vous êtes autorisé à utiliser.
APIXO
Head Swap
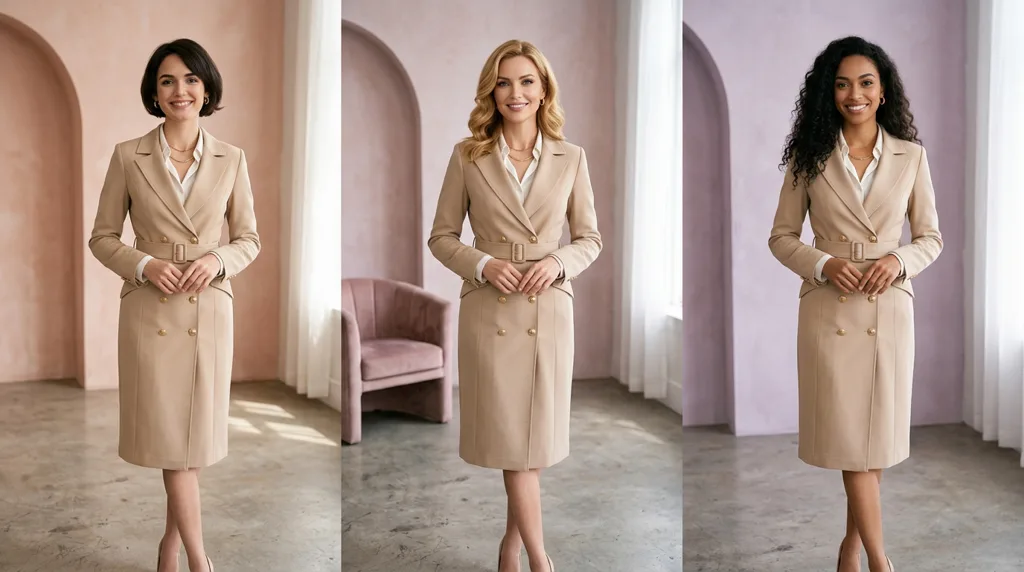
Head Swap est l'API image-vers-image d'APIXO qui remplace l'intégralité de la tête sur une photo cible par celle d'une photo de référence, pour les portraits qui vous appartiennent ou que vous êtes autorisé à utiliser.
APIXO
Video Upscaler
Video Upscaler est l'API vidéo-vers-vidéo d'APIXO qui améliore une vidéo source pour la porter aux résolutions 1080p, 2K ou 4K, avec une facturation à la seconde de vidéo source.
APIXO
Video Watermark Remover
Video Watermark Remover est l'API de nettoyage vidéo-vers-vidéo d'APIXO permettant de supprimer les filigranes, logos et superpositions de texte visibles d'une vidéo que vous possédez ou êtes autorisé à modifier, avec une facturation à la seconde de vidéo source.
APIXO
Z-Image LoRA Pro
Z-Image LoRA Pro est une API texte-image asynchrone optimisée pour des détails saisissants. Elle renvoie une image par requête et propose des préréglages de rapport d'aspect, des tailles en pixels précises jusqu'à 2560 de côté, la reproductibilité via la graine (seed) et une extension de prompt sans frais supplémentaires.
APIXO
Z-Image LoRA
Z-Image LoRA est une API texte-image asynchrone qui renvoie une image par requête. Elle propose des préréglages de rapport d'aspect, un contrôle précis de la taille en pixels, la reproductibilité via la graine (seed) et l'extension de prompt sans frais supplémentaires.
bytedance
Seedance 2.0 Mini
Seedance 2.0 Mini est une option économique d'APIXO pour les workflows ByteDance Seedance 2.0, proposant les modes texte-vidéo, première et dernière image et omni-référence, avec en option le son, la recherche web et une sortie 480p/720p.
Alibaba
Wan 2.6 Image
Wan 2.6 Image est le modèle texte-image et image-image d'Alibaba qui permet de contrôler le prompt, le prompt négatif, le format d'image, la taille du lot et la valeur de départ (seed) facultative.
Alibaba
Wan 2.5 Image
Wan 2.5 Image est le modèle de génération d'images d'Alibaba optimisé pour le traitement par lots pour les flux de travail texte-image et image-image, générant par défaut quatre images par requête.
APIXO
Image Upscaler
Agrandisseur d'image est l'API d'APIXO dédiée à l'amélioration d'images individuelles, permettant un agrandissement 2K, 4K et 8K avec un contrôle des formats de sortie JPG, PNG et WEBP.
APIXO
Image Watermark Remover
Suppresseur de filigranes est l'API autorisée d'APIXO pour le nettoyage d'images individuelles, permettant de supprimer les marques d'échantillon ou les superpositions des images dont vous êtes propriétaire ou que vous êtes autorisé à traiter.
kling
Kling 3.0 Turbo
Kling 3.0 Turbo est le modèle de génération vidéo rapide de Kuaishou pour les workflows texte-vers-vidéo et image-vers-vidéo à partir d'une seule image, avec une sortie en 720p/1080p et des clips de 3-15 secondes.
MiniMax
MiniMax Image 01
MiniMax Image 01 est le modèle texte-image et image-image de MiniMax, avec optimisation des prompts, contrôle flexible des dimensions, préréglages 1K/2K et jusqu'à 9 images générées par tâche.
MiniMax
MiniMax Speech 2.8
MiniMax Speech 2.8 est une API de synthèse vocale asynchrone dotée de modes de qualité HD et turbo, de voix prédéfinies, de la prise en charge de voice_id MiniMax personnalisés, d'un contrôle des émotions, de dictionnaires de prononciation et de paramètres de sortie multilingues.
MiniMax
MiniMax Voice
MiniMax Voice crée des ID de voix personnalisés et réutilisables à partir d'une description textuelle de la voix ou d'un seul clip audio de référence public, puis renvoie un aperçu audio pour validation.
hailuo
Hailuo 2.3
Hailuo 2.3 est le modèle vidéo asynchrone de MiniMax avec des modes Standard et Pro pour la génération de vidéos à partir de texte et d'images. Le mode Standard prend en charge 6s/10s à 768p, tandis que le mode Pro renvoie une sortie fixe de 5s à 1080p.
hailuo
Hailuo 2.3 Fast
Hailuo 2.3 Fast est le modèle de conversion d'image en vidéo de MiniMax optimisé pour la vitesse, avec des modes Standard et Pro. Le mode Standard prend en charge 6s/10s à 768p, tandis que le mode Pro renvoie une sortie fixe de 6s à 1080p.
xai
Grok Image
Grok Image est le modèle de génération d'images de xAI conçu pour les workflows texte-vers-image et image-vers-image, avec un contrôle simple du format d'image et un traitement asynchrone des tâches. Le mode texte-vers-image génère 6 images par requête sur APIXO.
Alibaba
Wan 2.2 Animate
L'API Wan 2.2 Animate est le modèle d'animation de personnages d'Alibaba qui combine une image source et une vidéo de mouvement pour générer des animations stylisées avec un comportement d'animation/remplacement.
xai
Grok Video
Grok Video est le modèle de génération vidéo asynchrone de xAI pour les workflows texte-vidéo et image-vidéo, avec continuation facultative via task_id + index et contrôle du style.
kling
Kling 3.0 Std
Kling 3.0 Std est le modèle de génération vidéo de qualité standard de Kuaishou. Il propose des modes texte-vers-vidéo, image-vers-vidéo et de contrôle du mouvement, et prend en charge des clips d'une durée maximale de 15 secondes, avec une génération de son en option et des formats d'image flexibles.
MeiGen
InfiniteTalk
InfiniteTalk convertit une photo et de l'audio en vidéos d'avatars parlants ou chantants avec une synchronisation labiale précise. Il prend en charge des vidéos d'une durée maximale de 10 minutes en résolution 480p ou 720p.
Nano Banana 2
Nano Banana 2 est le modèle de génération d'images haute résolution de Google, offrant un contrôle de sortie 1K/2K/4K, des prompts de 20,000 caractères et la prise en charge de jusqu'à 14 images de référence. Le contexte Google Search n'est pas exposé comme contrôle actif dans la route actuelle d'APIXO.
vidu
Vidu Q3
Vidu Q3 est un modèle de génération de vidéo facturé à la seconde qui combine les flux de travail Standard et Turbo texte-vidéo et image-vidéo en une seule API. Il prend en charge l'animation d'une seule image, les transitions entre la première et la dernière image, le son et la musique de fond (BGM) en option, et une sortie jusqu'à 1080p.
kling
Kling 2.5 Turbo Pro
Kling 2.5 Turbo Pro est le modèle de génération vidéo à haute vitesse de Kuaishou pour la création texte-vers-vidéo et image-vers-vidéo. Il prend en charge les clips de 5-10 secondes, les images de fin de séquence en option, le contrôle du format d'image en mode texte-vers-vidéo, ainsi que les prompts négatifs et le guidage d'échelle CFG.
Lightricks
LTX-2 19B
LTX-2 19B est le transformeur de diffusion 19B open source de Lightricks pour la génération de vidéos cinématiques. Il prend en charge les workflows texte-vers-vidéo et image-vers-vidéo, le conditionnement LoRA et les sorties haute-fidélité jusqu'à 1080p dans l'API.
kling
Kling 2.1
Kling 2.1 est le modèle vidéo multi-niveaux de Kuaishou, proposant les modes Standard, Pro et Master pour la création de vidéos à partir d'images et de textes. Il prend en charge des clips de 5-10 secondes, des images de fin facultatives pour le mode Pro et le contrôle du format d'image pour la génération texte-vers-vidéo en mode Master.
kling
Kling 2.6
Kling 2.6 est le modèle vidéo audiovisuel natif de Kuaishou qui génère la vidéo, la parole, les effets sonores et l'ambiance en une seule passe. Il prend en charge la création text-to-audio-visual et image-to-audio-visual avec une génération de voix en chinois et en anglais, et des clips allant jusqu'à 10 secondes.
suno
Suno V6
Le dernier modèle text-to-music de Suno qui génère deux morceaux de qualité professionnelle par appel, avec des files d'attente plus rapides et des voix plus riches.
Claude
Claude Opus 4.8
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Claude
Claude Opus 4.7
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Claude
Claude Opus 4.6
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Claude
Claude Opus 4.5 20251101
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Claude
Claude Sonnet 4.6
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Claude
Claude Sonnet 4.5
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Claude
Claude Sonnet 4.5 20250929
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Claude
Claude Haiku 4.5 20251001
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.6 Sol
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.6 Terra
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.6 Luna
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.5
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.4
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.4 Mini
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.3-Codex
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.2
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5.2-Codex
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-5 Mini
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
OpenAI
GPT-6 Astra
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Gemini
Gemini 3.6 Flash
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Gemini
Gemini 3.5 Flash
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Gemini
Gemini 3.1 Pro Preview
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Gemini
Gemini 3 Flash Preview
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Gemini
Gemini 2.5 Pro
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Gemini
Gemini 3.7 Flash
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Gemini
Gemini 3.8 Flash
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Grok
Grok 4.5
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
Grok
Grok 4.6
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
APIXO
APIXO Spicy Chat
Passerelle compatible OpenAI pour le chat, les agents, le raisonnement et la génération structurée.
kling
Kling 4.0
Kling 4.0 génère des vidéos à partir de texte, d'images-clés ordonnées, d'images et de vidéos de référence, de sujets nommés et de voix.
APIXO
Qwen Image Edit LoRA
Modifiez une image principale à l'aide d'un prompt texte et de références visuelles facultatives, tout en conservant sa composition et ses dimensions.
Nano Banana 2.1
Générez et retouchez des images avec jusqu'à 10 références et 1K, 2K ou 4K sorties.
Black Forest Labs
FLUX 3 Image
Générez une image à partir de texte ou retouchez jusqu'à 10 images de référence avec 1K, 2K ou 4K sorties.
Alibaba
Wan 3.0 Video LoRA
Wan 3.0 Video LoRA prend en charge les workflows texte-vers-vidéo, image-vers-vidéo et référence-vers-vidéo avec une durée intelligente. Le mode référence accepte les entrées de type image, vidéo et audio.
Alibaba
Wan 3.0 Video Pro LoRA
Wan 3.0 Video Pro LoRA relève le plafond des performances de sortie à 4K pour les workflows texte-vers-vidéo, image-vers-vidéo et référence-vers-vidéo, avec une durée intelligente et des références image, vidéo et audio.
Black Forest Labs
FLUX 3
FLUX 3 est le modèle vidéo multimodal de Black Forest Labs pour la génération texte-vidéo, image-vidéo et l'extension de vidéo, avec audio natif et sortie MP4 en 720p ou 1080p.
xai
Grok Imagine Video 1.5
Grok Imagine Video 1.5 anime les images de référence, les premières et dernières images, les images clés temporisées et les images en boucle, avec des limites d'entrée dépendant de la résolution.
Alibaba
Wan 3.0 Video
Wan 3.0 Video prend en charge les workflows texte-vers-vidéo, image-vers-vidéo et référence-vers-vidéo avec une durée intelligente. Le mode référence accepte les entrées de type image, vidéo, audio, fichier et lien.
kling
Kling 3.0 Omni
Kling 3.0 Omni expose neuf modes via un seul point de terminaison : les niveaux standard, pro et 4K répartis sur les workflows text-to-video, image-to-video et reference-to-video.
MiniMax
MiniMax H3 LoRA
MiniMax H3 LoRA est la version stylisée LoRA de MiniMax H3 avec une sortie 480p et 768p. La génération de vidéo à partir de références peut être conditionnée par des images, de l'audio et des vidéos.
Veo 3.1
Le modèle vidéo IA amélioré de Google DeepMind, doté de routes lite, fast et quality, d'un contrôle de la durée de 4/6/8 secondes, d'une sortie en 720p/1080p/4k et de workflows de référence multi-images.
Alibaba
Wan 2.5
Wan 2.5 est le modèle de génération de vidéo d'Alibaba pour la génération texte-vers-vidéo et image-vers-vidéo, avec une entrée audio facultative, une sortie 480p/720p/1080p, des clips de 5 ou 10 secondes et l'expansion de prompt.
OpenAI
Sora 2
Informations archivées. Sora 2 n'est plus disponible sur APIXO.
seedream
Seedream 4.5
Seedream 4.5 est un puissant modèle d'AI text-to-image et image-to-image qui offre une génération d'images de haute qualité et prend en charge les résolutions 2K et 4K.