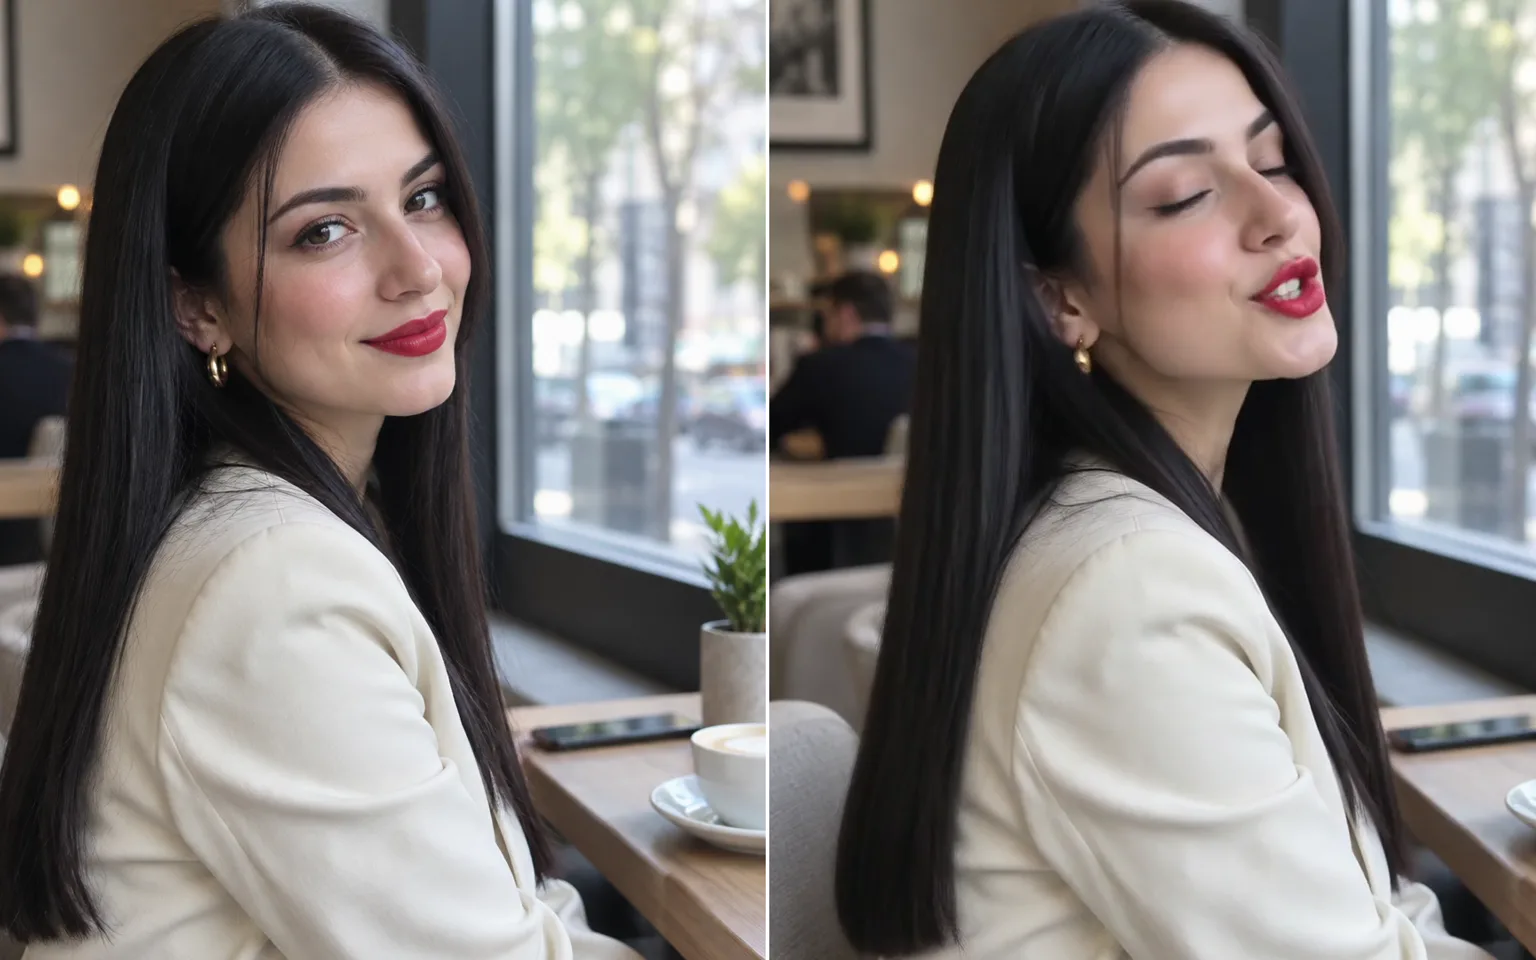


AI 照片说话是由一张静态人像和一个音频文件生成的视频。模型会驱动面部动画,让唇形、表情和头部动作跟随声音变化,生成照片中人物仿佛在说话或唱歌的视频片段。


AI 照片说话可将一张静态人像和一段音频转化为人物开口说话的视频,唇形、面部表情和头部动作都会跟随声音变化。上传一张清晰的照片,添加说话或歌唱音频,无需拍摄任何人即可生成说话视频。
把一张肖像变成用您自己录制的声音讲述的个人留言、邀请或感谢。
无需安排拍摄或布置灯光,就能为产品演示、课程开场或公告配上一张会说话的脸。
为插画或生成的角色肖像配上旁白,让角色仿佛亲口讲述故事。
为同一张肖像搭配多种语言的配音,让每个版本都有一位统一的出镜主持人。
使用人声轨道驱动肖像,可用于音乐宣传、歌曲翻唱或趣味帖子,让面部口型与歌词同步。
在正式投入完整视频制作之前,先预览数字主持人或品牌吉祥物说话时的样子。
用一张照片和您已录好的配音,为短视频、Reels 和频道片头添加一位会说话的主持人。
利用已批准的品牌图像和已授权的配音录音,制作代言人风格的短片和本地化广告版本。
把课程脚本变成由亲切面孔讲解的旁白短片,帮助学习者跟上录制的讲解内容。
在获得照片中人物同意的前提下,用您自己的照片制作轻松有趣的生日和节日祝福。
添加一张清晰的正面照片,确保面部光线充足且嘴部未被遮挡。您可以在同一字段中添加可选的蒙版图像。
上传演讲、旁白或歌曲文件。可选择描述想要的表情,选择输出分辨率,并查看点数预估。
提交任务,然后打开声音播放完成的视频,并确认在整个音轨播放过程中口型都能保持同步。
使用清晰的正面人像,并确保嘴和下巴完全可见。
在安静的房间里录音,并剪掉不需要的长时间静音或背景音乐。
文字说明请保持简短,聚焦于表情或情绪;说什么内容已经由音频决定了。
先用较低分辨率检查口型同步和表情,再用较高设置重新生成最终版本。
只使用您拥有或已获授权使用的照片和声音,切勿将结果当作真实言论发布。
AI 照片说话是由一张静态人像和一个音频文件生成的视频。模型会驱动面部动画,让唇形、表情和头部动作跟随声音变化,生成照片中人物仿佛在说话或唱歌的视频片段。
不能。输入是一张照片和一个音频文件。为现有视频重新对口型是另一种工作流;此工具始终从静态图片开始。
背景噪音少、清晰的说话声或人声,能带来最准确的口型动作。上传栏会列出支持的音频格式以及单条音轨的最大时长。
清晰、光线充足且面部无遮挡的肖像效果最好。侧脸、浓重阴影、墨镜、遮住嘴巴的头发或靠近面部的手,都会让动画效果不够逼真。
必须获得本人许可。未经同意,请勿制作冒充真实人物、误导观众或让某人说出其未说过的话的视频,并遵守每个发布平台的规则。
生成以按量付费的方式消耗点数。“生成”按钮旁的预估反映了您当前的输入和分辨率,方便您在提交前查看预计消耗。
上传一张人像,添加您的音频,生成一段人脸随声音同步说话的视频。
立即尝试