

모델 카탈로그
최신 및 인기 모델
사용자들이 가장 먼저 사용하는 모델로 시작한 후, 출력 유형이나 워크플로우에 따라 전체 카탈로그를 검색하고 필터링하세요.
모델 유형
워크플로우
96 모델
전체 카탈로그 표시 중
bytedance
Seedance 2.0
Seedance 2.0는 ByteDance의 멀티모달 동영상 모델로, 텍스트-동영상 변환, 첫 프레임 및 마지막 프레임, 옴니 레퍼런스 모드를 지원합니다. APIXO 독점: 무제한 동시성, 실제 인물 초상화 지원, 숨겨진 기능.
bytedance
Seedance 2.0 Fast
Seedance 2.0 Fast는 ByteDance Seedance 2.0 워크플로를 위한 APIXO 라우트로, 텍스트 투 비디오, 첫 프레임 및 마지막 프레임, 옴니 레퍼런스 모드와 함께 사운드, 웹 검색, 480p/720p 출력을 옵션으로 제공합니다.
OpenAI
GPT-Image-2
GPT-Image-2는 OpenAI의 차세대 이미지 모델로, 더욱 강력한 사실성, 깔끔한 이미지 편집, 선명한 이미지 내 텍스트 렌더링 기능을 제공합니다.
Alibaba
HappyHorse
HappyHorse는 Alibaba의 영상 생성 및 편집 모델로, 텍스트-투-비디오, 이미지-투-비디오, 레퍼런스 기반 생성, 영상 편집 워크플로와 720p/1080p 출력을 지원합니다.
Black Forest Labs
Flux 2
통합 1K/2K 요금제와 약 30s의 생성 시간을 제공하는 BFL의 최신 텍스트-이미지 및 이미지-이미지 변환용 Pro & Flex 파이프라인입니다.
Nano Banana Pro
Nano Banana Pro는 추론 기반 이미지 생성, 네이티브 4K 출력, 다국어 타이포그래피, 공간적으로 정밀한 구성을 지원하는 Google의 Gemini 3 Pro Image 라우트입니다. APIXO는 이 라우트에서 Search Grounding을 활성 제어 기능으로 제공하지 않습니다.
midjourney
Midjourney
Midjourney는 예술적이고 고품질의 결과물로 유명한 고급 AI 이미지 생성 모델입니다. 텍스트-이미지 변환, 이미지-이미지 변환, 이미지 편집, Vary 및 업스케일 워크플로를 지원합니다.
Black Forest Labs
Flux Kontext
강화된 프롬프트 이해력으로 우수한 품질의 결과물을 제공하는 전문가급 이미지 생성.
OpenAI
GPT-Image-1
GPT-Image-1는 OpenAI의 고급 멀티모달 모델로, 자연어 이해를 기반으로 고품질 이미지를 생성합니다.
Nano Banana
Gemini 2.5 Flash Image Preview(일명 Nano Banana)는 자연어 기반 이미지 생성 및 편집에 탁월한 고급 AI 모델입니다. 물리 법칙을 반영한 극사실적 비주얼과 매끄러운 스타일 변환을 구현합니다.
OpenAI
GPT-Image-2.5
GPT Image 2.5으로 이미지를 생성하고 개선하세요. 텍스트 설명이나 참고 사진을 제품 비주얼, 인물 사진, 일러스트레이션으로 변환한 다음, 중요한 디테일을 세밀하게 조정할 수 있습니다.
bytedance
Seedance 2.5
Seedance 2.5은 더 긴 레퍼런스 기반 스토리텔링을 위한 ByteDance의 시청각 동영상 모델입니다. 타임라인 기반 디렉팅, 멀티모달 크리에이티브 가이던스, 동기화된 사운드, 다국어 성능, 선택적 수정 기능을 결합하여 프로덕션 팀이 단편적인 짧은 클립 대신 연결된 장면을 개발하도록 돕습니다.
Alibaba
Qwen Image 3.0
Qwen Image 3.0은(는) Alibaba의 text-to-image 및 image-to-image 모델로, 1K 및 2K 출력, 15가지 종횡비, 최대 3개의 참조 이미지, 선택적 프롬프트 확장 기능을 지원합니다. 두 해상도 등급 모두 동일한 요금으로 청구됩니다.
Alibaba
Qwen Image 3.0 Pro
Qwen Image 3.0 Pro는 동일한 text-to-image 및 image-to-image 계약에 대한 Alibaba의 상위 티어 옵션으로, 1K 및 2K 출력의 가격을 별도로 책정하여 초안과 최종 결과물에 대한 청구 비용을 다르게 할 수 있습니다.
MiniMax
MiniMax H3
MiniMax H3는 텍스트, 이미지, 동영상, 오디오 컨텍스트를 하나의 생성 워크플로에 결합하는 범용 멀티모달 동영상 모델입니다. 네이티브 스테레오 사운드로 최대 2K초 및 15초 길이의 동영상을 생성하며, 첫 프레임과 마지막 프레임 제어, 혼합 미디어 레퍼런스, 모션 트랜스퍼, 멀티샷 스토리텔링, 지침 기반 동영상 편집 기능을 지원합니다.
seedream
Seedream 5.0 Pro
Seedream 5.0 Pro는 텍스트-이미지 및 이미지-이미지 생성을 위한 ByteDance의 프리미엄 단일 이미지 모델로, 1K/2K 해상도, 8가지 종횡비, 최대 10개의 참조 이미지, 그리고 엄격한 사용자 지정 크기 제어를 지원합니다.
bytedance
Seedance 1.5 Pro
Seedance 1.5 Pro는 빠른 텍스트-동영상 및 이미지-동영상 생성을 위한 ByteDance의 초당 과금 동영상 모델로, 480p/720p/1080p 출력, 선택적 사운드, 종횡비 제어, 고정 렌즈 카메라 안정성 기능을 제공합니다.
Gemini Omni
Gemini Omni는 텍스트, 이미지 레퍼런스, 소스 동영상, 재사용 가능한 오디오 애셋, 캐릭터 애셋 ID를 사용하여 동영상을 제작하는 Google의 멀티모달 동영상 생성 모델입니다.
Alibaba
Wan 2.7 Image
Wan 2.7 Image는 텍스트-이미지 변환, 참조 기반 이미지 생성, 이미지 편집, 연속 이미지, 고해상도 Omni Image Pro 워크플로를 위한 Alibaba의 옴니-이미지 API입니다.
Alibaba
Wan 2.7
Wan 2.7은 텍스트-비디오 변환, 이미지-비디오 변환, 레퍼런스 기반 생성 및 비디오 편집 워크플로우를 위한 알리바바의 비디오 생성 및 편집 모델로, 선택적 오디오 입력과 720p/1080p 출력을 지원합니다.
Alibaba
Wan 2.6
Wan 2.6은 텍스트, 이미지, 플래시 이미지, 레퍼런스, 플래시 레퍼런스 워크플로우를 위한 알리바바의 다중 모드 비디오 생성 모델로, 선택적 오디오 입력과 720p/1080p 출력을 지원합니다.
seedream
Seedream 5.0
Seedream 5.0은(는) 실시간 웹 검색, 제어 가능한 편집, 논리적 추론 기능을 갖춘 ByteDance의 차세대 AI 이미지 모델입니다. 2K/3K 해상도의 텍스트-이미지 및 이미지-이미지 변환, 다양한 종횡비, 최대 14개의 참조 이미지를 지원합니다.
OpenAI
Sora 2 Pro
보관된 정보입니다. Sora 2 Pro는 더 이상 APIXO에서 제공되지 않습니다.
APIXO
Face Swap
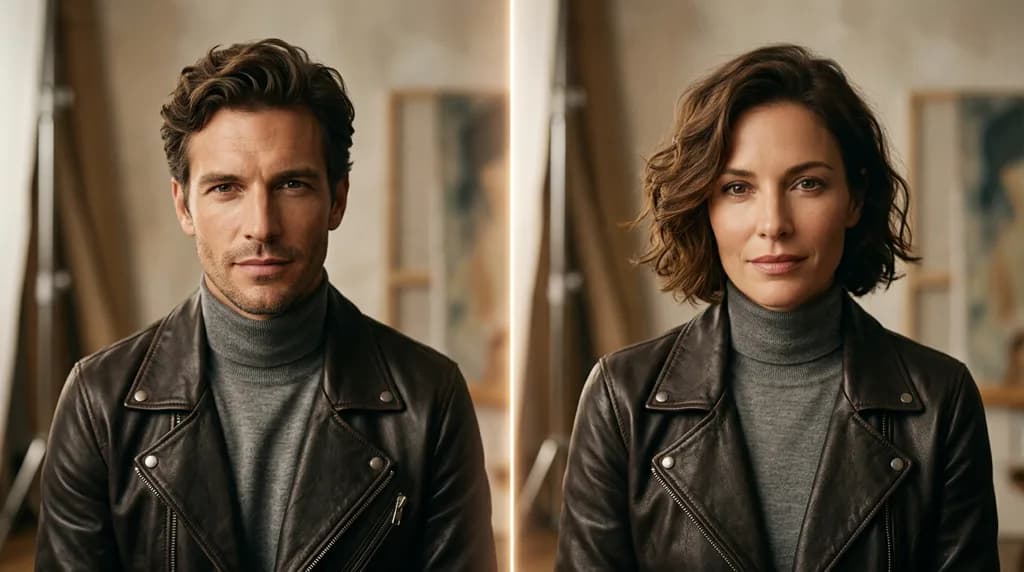
Face Swap은 직접 소유하거나 사용할 권한이 있는 인물 사진을 대상으로, 대상 사진 속 얼굴을 참조 사진의 얼굴로 교체해 주는 APIXO의 이미지 투 이미지(Image-to-Image) API입니다.
APIXO
Head Swap
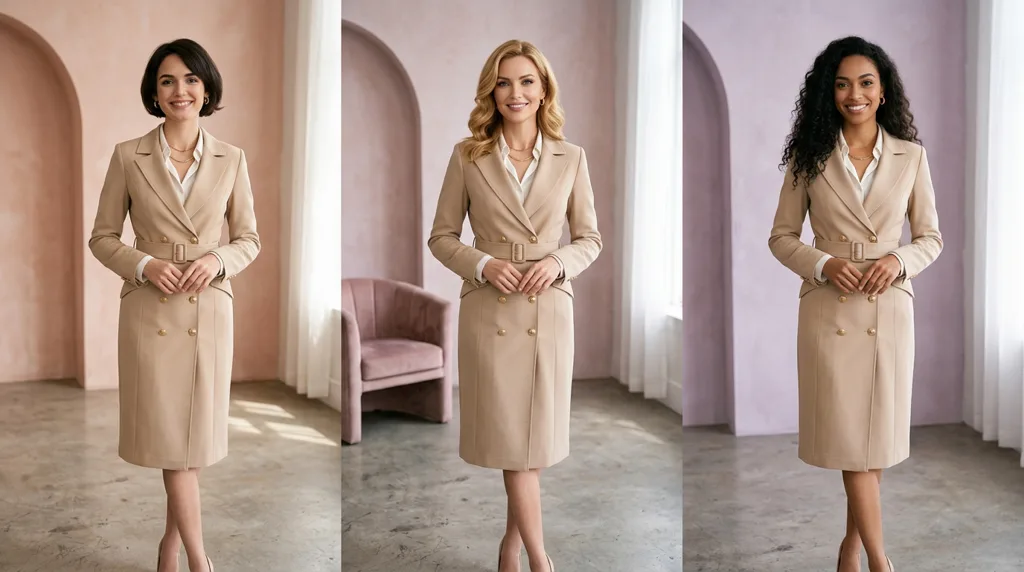
헤드 스왑은 APIXO의 이미지 투 이미지 API로, 소유하고 있거나 사용할 권한이 있는 인물 사진을 대상으로 하며 대상 사진 한 장의 머리 전체를 참조 사진 한 장의 머리로 교체합니다.
APIXO
Video Upscaler
동영상 업스케일러는 원본 동영상을 1080p, 2K 또는 4K 화질로 향상시키는 APIXO의 video-to-video API이며, 원본 동영상 초당 요금이 부과됩니다.
APIXO
Video Watermark Remover
동영상 워터마크 제거기는 소유하거나 수정할 권한이 있는 동영상에서 가시적인 워터마크, 로고, 텍스트 오버레이를 제거하는 APIXO의 video-to-video 클린업 API이며, 원본 동영상 초당 요금이 부과됩니다.
APIXO
Z-Image LoRA Pro
Z-Image LoRA Pro는 생생한 디테일 표현에 최적화된 비동기 텍스트-이미지 API로, 요청당 하나의 이미지를 반환하며 종횡비 프리셋, 한 변당 최대 2560픽셀까지의 정확한 픽셀 크기 지정, 시드 재현성 및 추가 비용 없는 프롬프트 확장 기능을 제공합니다.
APIXO
Z-Image LoRA
Z-Image LoRA는 요청당 하나의 이미지를 반환하는 비동기 텍스트-이미지 API로, 종횡비 프리셋, 정확한 픽셀 크기 제어, 시드 재현성 및 추가 비용 없는 프롬프트 확장 기능을 제공합니다.
bytedance
Seedance 2.0 Mini
Seedance 2.0 Mini는 ByteDance Seedance 2.0 워크플로를 위한 저비용 APIXO 경로로, 텍스트-동영상 변환, 첫 프레임 및 마지막 프레임, 옴니 레퍼런스 모드를 제공하며 사운드, 웹 검색 및 480p/720p 출력을 옵션으로 지원합니다.
Alibaba
Wan 2.6 Image
Wan 2.6 Image는 프롬프트, 네거티브 프롬프트, 종횡비, 배치 수, 선택적 시드 제어 기능을 갖춘 Alibaba의 텍스트-이미지 및 이미지-이미지 변환 모델입니다.
Alibaba
Wan 2.5 Image
Wan 2.5 Image는 텍스트-이미지 및 이미지-이미지 워크플로에 사용되는 Alibaba의 배치 처리 친화적인 이미지 생성 모델로, 요청당 기본적으로 4개의 이미지를 생성합니다.
APIXO
Image Upscaler
이미지 업스케일러는 2K, 4K, 8K 업스케일링을 지원하고 JPG, PNG, WEBP 출력 형식 제어 기능을 갖춘 APIXO의 단일 이미지 향상 API입니다.
APIXO
Image Watermark Remover
이미지 워터마크 리무버는 소유하고 있거나 처리 권한이 있는 이미지에서 샘플 마크나 오버레이를 제거하는 APIXO의 공인 단일 이미지 정리 API입니다.
kling
Kling 3.0 Turbo
Kling 3.0 Turbo는 텍스트-동영상 및 단일 이미지-동영상 워크플로를 위한 Kuaishou의 빠른 동영상 생성 모델입니다. 720p/1080p 출력과 3-15초 클립을 지원합니다.
MiniMax
MiniMax Image 01
MiniMax Image 01은 MiniMax의 텍스트-이미지 및 이미지-이미지 변환 모델입니다. 프롬프트 최적화, 유연한 크기 제어, 1K/2K 사전 설정 기능을 제공하며 작업당 최대 9개의 이미지를 생성할 수 있습니다.
MiniMax
MiniMax Speech 2.8
MiniMax Speech 2.8은 비동기식 텍스트 음성 변환 API입니다. HD 및 터보 품질 모드, 사전 설정된 음성, 맞춤형 MiniMax voice_id 지원, 감정 제어, 발음 사전, 다국어 출력 설정을 제공합니다.
MiniMax
MiniMax Voice
MiniMax Voice는 텍스트로 설명된 음성 디자인 또는 단일 공개 참조 오디오 클립으로 재사용 가능한 맞춤형 음성 ID를 생성한 다음, 검증을 위해 미리 듣기 오디오를 반환합니다.
hailuo
Hailuo 2.3
Hailuo 2.3는 텍스트-투-비디오 및 이미지-투-비디오 생성을 위한 MiniMax의 비동기 영상 모델로, 스탠다드 및 프로 모드를 지원합니다. 스탠다드 모드는 768p에서 6초/10초를 지원하는 반면, 프로 모드는 1080p에서 고정 5초 길이의 결과물을 반환합니다.
hailuo
Hailuo 2.3 Fast
Hailuo 2.3 Fast는 MiniMax의 속도에 최적화된 이미지-투-비디오 모델로, 스탠다드 및 프로 모드를 제공합니다. 스탠다드 모드는 768p에서 6초/10초를 지원하고, 프로 모드는 1080p에서 고정 6초 길이의 결과물을 반환합니다.
xai
Grok Image
Grok Image는 xAI의 이미지 생성 모델로, 간단한 종횡비 제어와 비동기 작업 전달 기능을 통해 텍스트-이미지 및 이미지-이미지 워크플로를 지원합니다. APIXO에서 텍스트-이미지 변환 시 요청당 6개의 이미지를 반환합니다.
Alibaba
Wan 2.2 Animate
Wan 2.2 Animate API는 알리바바의 캐릭터 애니메이션 모델로, 하나의 소스 이미지와 하나의 모션 비디오를 결합하여 애니메이트/대체 동작으로 스타일화된 애니메이션 결과물을 생성합니다.
xai
Grok Video
Grok Video는 텍스트-투-비디오 및 이미지-투-비디오 워크플로를 위한 xAI의 비동기 영상 생성 모델로, task_id + index를 통한 연속 작업 및 스타일 제어 옵션을 제공합니다.
kling
Kling 3.0 Std
Kling 3.0 Std는 Kuaishou의 표준 품질 동영상 생성 모델로, 텍스트-동영상, 이미지-동영상, 모션 제어 모드를 지원합니다. 최대 15초 길이의 클립을 지원하며, 선택적으로 사운드를 생성하고 종횡비를 유연하게 조절할 수 있습니다.
MeiGen
InfiniteTalk
InfiniteTalk는 사진 한 장과 오디오를 사용하여 정교한 립싱크로 말하거나 노래하는 아바타 영상을 생성합니다. 최대 10분 길이, 480p 또는 720p 해상도를 지원합니다.
Nano Banana 2
Nano Banana 2은(는) 1K/2K/4K 출력 제어, 20,000자 프롬프트, 최대 14개의 참조 이미지를 지원하는 Google의 고해상도 이미지 생성 모델입니다. APIXO의 현재 라우트에서는 Google Search 컨텍스트가 활성 제어 기능으로 제공되지 않습니다.
vidu
Vidu Q3
Vidu Q3는 표준 및 터보(Turbo) text-to-video와 image-to-video 워크플로를 하나의 API에 결합한 초당 과금 방식 동영상 생성 모델입니다. 단일 이미지 애니메이션, 첫 프레임과 마지막 프레임 간 전환, 사운드 및 BGM 추가 옵션, 최대 1080p 해상도 출력을 지원합니다.
kling
Kling 2.5 Turbo Pro
Kling 2.5 Turbo Pro는 텍스트-동영상 및 이미지-동영상 제작을 위한 Kuaishou의 고속 동영상 모델입니다. 5-10초 클립, 선택적 마지막 프레임 이미지, 텍스트-동영상용 종횡비 제어는 물론, 제외 프롬프트와 CFG 스케일 가이드까지 지원합니다.
Lightricks
LTX-2 19B
LTX-2 19B은 영화 같은 동영상 생성을 위한 Lightricks의 오픈소스 19B 확산 트랜스포머입니다. 텍스트-동영상 및 이미지-동영상 워크플로, LoRA 컨디셔닝을 지원하며 API에서 최대 1080p의 고화질 출력이 가능합니다.
kling
Kling 2.1
Kling 2.1은 Kuaishou의 다중 계층 비디오 모델로, Standard, Pro, Master 모드를 사용하여 이미지-비디오 및 텍스트-비디오를 생성합니다. 5-10초 클립, Pro 모드용 선택적 테일 이미지, Master 모드의 텍스트-비디오용 화면 비율 제어를 지원합니다.
kling
Kling 2.6
Kling 2.6는 Kuaishou의 네이티브 시청각 비디오 모델로, 비디오, 음성, 음향 효과, 주변음을 단일 패스로 생성합니다. 중국어 및 영어 음성 생성을 포함한 텍스트-시청각 및 이미지-시청각 생성을 지원하며, 최대 10초 길이의 클립을 만들 수 있습니다.
suno
Suno V6
최신 Suno 텍스트-투-뮤직 모델로, 호출당 2개의 완성도 높은 곡을 반환하며 더 빠른 대기열과 더욱 풍부한 보컬을 제공합니다.
Claude
Claude Opus 4.8
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Claude
Claude Opus 4.7
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Claude
Claude Opus 4.6
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Claude
Claude Opus 4.5 20251101
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Claude
Claude Sonnet 4.6
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Claude
Claude Sonnet 4.5
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Claude
Claude Sonnet 4.5 20250929
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Claude
Claude Haiku 4.5 20251001
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.6 Sol
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.6 Terra
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.6 Luna
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.5
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.4
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.4 Mini
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.3-Codex
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.2
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5.2-Codex
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-5 Mini
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
OpenAI
GPT-6 Astra
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Gemini
Gemini 3.6 Flash
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Gemini
Gemini 3.5 Flash
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Gemini
Gemini 3.1 Pro Preview
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Gemini
Gemini 3 Flash Preview
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Gemini
Gemini 2.5 Pro
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Gemini
Gemini 3.7 Flash
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Gemini
Gemini 3.8 Flash
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Grok
Grok 4.5
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
Grok
Grok 4.6
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
APIXO
APIXO Spicy Chat
채팅, 에이전트, 추론, 구조화된 생성을 위한 OpenAI 호환 게이트웨이입니다.
kling
Kling 4.0
Kling 4.0은 텍스트, 순차적 키프레임, 참조 이미지 및 동영상, 지정된 피사체, 음성으로 동영상을 생성합니다.
APIXO
Qwen Image Edit LoRA
구도와 크기를 그대로 유지하면서 텍스트 프롬프트 및 선택적 시각적 참조를 활용해 원본 이미지를 편집합니다.
Nano Banana 2.1
최대 10개의 레퍼런스를 사용해 이미지를 생성 및 편집하고 1K, 2K 또는 4K개의 결과물을 출력합니다.
Black Forest Labs
FLUX 3 Image
텍스트로 이미지 한 개를 생성하거나, 최대 10개의 참조 이미지를 편집하여 1K, 2K 또는 4K개의 결과물을 출력합니다.
Alibaba
Wan 3.0 Video LoRA
Wan 3.0 Video LoRA는 스마트 길이 조절 기능으로 텍스트-영상, 이미지-영상, 참조-영상 워크플로를 지원합니다. 참조 모드는 이미지, 영상, 오디오 입력을 지원합니다.
Alibaba
Wan 3.0 Video Pro LoRA
Wan 3.0 Video Pro LoRA는 텍스트-영상, 이미지-영상, 참조-영상 워크플로의 출력 한도를 4K까지 높였으며, 스마트 길이 조절과 이미지, 영상, 오디오 참조 기능을 지원합니다.
Black Forest Labs
FLUX 3
FLUX 3는 Black Forest Labs의 멀티모달 동영상 모델로, 텍스트-동영상 변환, 이미지-동영상 변환 및 동영상 확장 기능을 제공하며 네이티브 오디오와 함께 720p 또는 1080p MP4로 출력됩니다.
xai
Grok Imagine Video 1.5
Grok Imagine Video 1.5는 참조 이미지, 시작 및 종료 프레임, 시간 지정 키프레임, 루프 이미지를 애니메이션으로 구현하며, 해상도에 따른 입력 제한이 적용됩니다.
Alibaba
Wan 3.0 Video
Wan 3.0 Video는 스마트 길이 조절 기능으로 텍스트-영상, 이미지-영상, 참조-영상 워크플로를 지원합니다. 참조 모드는 이미지, 영상, 오디오, 파일, 링크 입력을 지원합니다.
kling
Kling 3.0 Omni
Kling 3.0 Omni는 단일 엔드포인트를 통해 텍스트-비디오, 이미지-비디오, 레퍼런스-비디오 워크플로에 걸쳐 standard, pro, 4K 등급의 9가지 모드를 제공합니다.
MiniMax
MiniMax H3 LoRA
MiniMax H3 LoRA는 480p 및 768p 출력을 제공하는 MiniMax H3의 LoRA 스타일화 버전입니다. 레퍼런스 이미지, 오디오, 동영상을 입력하여 레퍼런스 기반 동영상 생성을 유도할 수 있습니다.
Veo 3.1
Google DeepMind의 업그레이드된 AI 동영상 모델로, 라이트, 패스트, 퀄리티 경로, 4/6/8초 길이 제어, 720p/1080p/4k 출력 및 다중 이미지 레퍼런스 워크플로를 지원합니다.
Alibaba
Wan 2.5
Wan 2.5은 텍스트-비디오 변환 및 이미지-비디오 변환 워크플로우를 위한 알리바바의 비디오 생성 모델로, 선택적 오디오 입력, 480p/720p/1080p 출력, 5초 또는 10초 클립 및 프롬프트 확장 기능을 지원합니다.
OpenAI
Sora 2
보관된 정보입니다. Sora 2는 더 이상 APIXO에서 제공되지 않습니다.
seedream
Seedream 4.5
Seedream 4.5은(는) 고품질 이미지 생성을 제공하는 강력한 텍스트-이미지 변환 및 이미지-이미지 변환 AI 모델로, 2K 및 4K 해상도를 지원합니다.